Wilcoxon 符號等級檢定小整理

用 AI 的壞處 – 你幾乎可以問任何問題,它也會認真回答你。 問得愈有水準,答案的神念 [1] 禁制 [2] 就愈多層。我好奇心重,最近問了 AI 三五個大難題,所以它的答案累積起來已經有幾百層禁制了。我的靈力有限,先破解幾個相對簡單的。身為偽資料科學家,就先來整理這個 Wilcoxon [3] 符號等級檢定。

為什麼需要符號檢定?它主要是用來判斷數據是否達到統計上的顯著性。假設我用一個特殊手法 X ,想要降功耗。然後我拿了一顆 IC 來做實驗,測試改善前和改善後的功耗,一量果然降了 5 mW,這樣算有改進嗎? 還是要改進 5% 才算?又或者至少要減個 10 mW?Wilcoxon 符號等級檢定就是要解決這個問題 – 什麼是顯著性?

讓我先用 10 顆 IC 來舉例,稍後再回頭看最少需要幾顆 IC 來驗證?

mW12345678910
15181213141716151415
13151213131514131213

所謂符號檢定,就是要看改變的方向是否一致?是正號還是負號?

第一步:算出每顆 IC 的差異值(後-前)

#差異(後-前)
11513-2
21815-3
312120
413130
51413-1
61715-2
71614-2
81513-2
91412-2
101513-2

其中有 8 顆 IC 都同方向,有兩顆不變 (#3 和 #4),他們沒有方向。Wilcoxon 就不算這兩顆,有效樣本是 n = 8。

第二步:對剩下 8 個差異的絕對值排等級

剩下值的差異:-2, -3, -1, -2, -2, -2, -2, -2
絕對值:2, 3, 1, 2, 2, 2, 2, 2

排序:1, 2, 2, 2, 2, 2, 2, 3

  • 絕對值=1 → 排名第1 → rank=1
  • 絕對值=2(六個並列)→ 佔第2~7名 → 平均等級 = (2+3+4+5+6+7)/6 = 4.5
  • 絕對值=3 → 排名第8 → rank=8

代回原資料:

#差異等級正/負
1-24.5
2-38
5-11
6-24.5
7-24.5
8-24.5
9-24.5
10-24.5

全部 8 個都是負等級! 正等級總和 T+ = 0,負等級總和 T= 1+4.5×6+8 = 36

第三步:算期望值與變異數(n=8,含 ties 校正)

μT=n(n+1)4=8×94=18\mu_T = \frac{n(n+1)}{4} = \frac{8\times9}{4} = 18

未校正變異數:

n(n+1)(2n+1)24=8×9×1724=51\frac{n(n+1)(2n+1)}{24} = \frac{8\times9\times17}{24} = 51

因為有 6 個值並列(tie),要扣掉 ties 校正項:

t3t48=63648=21048=4.375\frac{t^3-t}{48} = \frac{6^3-6}{48} = \frac{210}{48} = 4.375

校正後變異數:

σT2=514.375=46.625σT=46.6256.828\sigma_T^2 = 51 – 4.375 = 46.625 \quad\Rightarrow\quad \sigma_T = \sqrt{46.625} \approx 6.828

其中,第一、二、三步的分母 4、24、48 都是常數,不是隨便設的 [4]。

第四步:算 Z 值

Z=T+μTσT=0186.8282.636Z = \frac{T_+ – \mu_T}{\sigma_T} = \frac{0 – 18}{6.828} \approx \boxed{-2.636}

第五步:算 p 值

p=2×P(Z>2.636)0.008p = 2\times P(Z’>2.636) \approx \boxed{0.008}

P 怎麼來? 它就是常態分佈 (μT , σT) ,超出 Z 值的左右兩邊長尾面積的和。
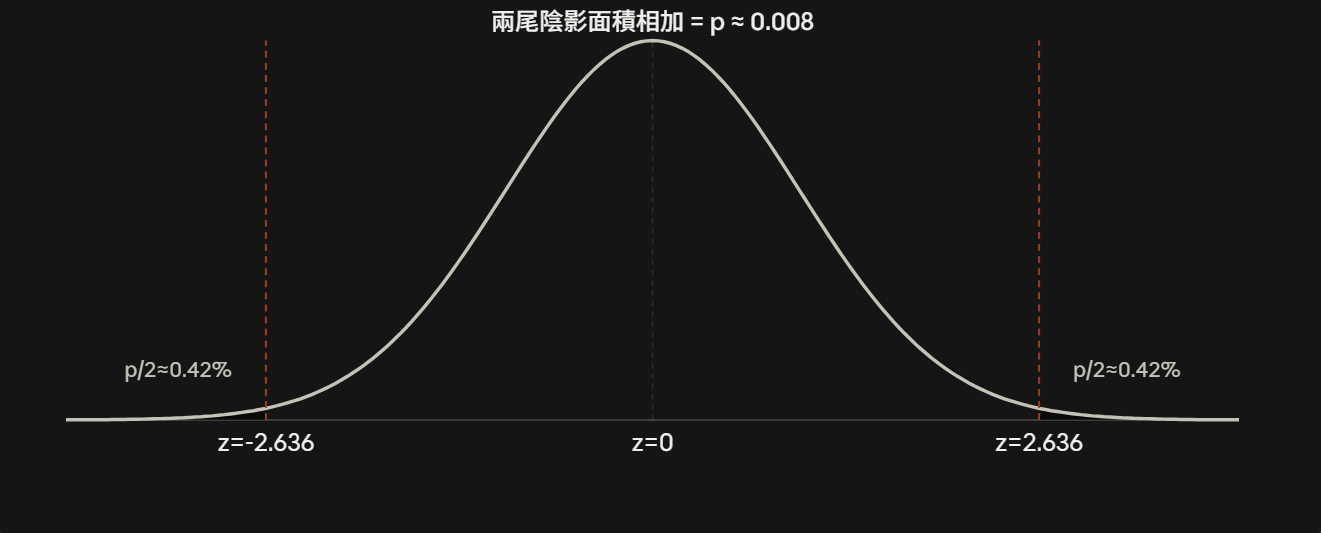
不用作圖,有三種方法解決:

  • 查表:統計課本後面附的「標準常態分布表」(Z table),直接查 Z=2.64 對應的累積機率,再算 1 減掉它、乘 2。
  • 公式(累積分布函數 CDF)

p=2×[1Φ(2.636)]p = 2\times[1-\Phi(2.636)]

其中 Φ 是標準常態的 CDF,這是一個已經被證明、寫死在數學公式/查表/軟體裡的函數,不需要「目測」曲線。

  • 軟體直接算:SPSS、Excel(=2*(1-NORM.S.DIST(2.636,TRUE)))、Python(scipy.stats.norm.sf)都是呼叫同一個 CDF 公式算出來的。

判定

  • 有效 n = 8(10 筆中 2 筆差異為 0 被排除)
  • 8 顆 IC 全部都是「後 < 前」,沒有一個例外 → 最極端的一致性
  • Z = -2.636,p = 0.008 < 0.05 = 5% → 達顯著差異,「後」顯著低於「前」

其中的 5% 就是一般人印象中,約定俗成的 α 顯著水準。所以 5% 是對的,但是不能只看一次的測試達到 5% 就過關。而且有效樣本 n ≤ 5 時,無論效果多完美都不可能顯著。

用 Wilcoxon 符號等級檢定的精確分布(exact test)計算「全部差異都同方向」這個最極端情況的雙尾 p 值:

n(配對數)最極端情況下的 p 值結果
50.0625❌ 不顯著
60.0312✅ 顯著
70.0156✅ 顯著
10(你這次)0.0020✅ 顯著

也就是說:n=6 是這個檢定理論上能達到顯著的最小樣本量(前提是 6 個有效樣本全部同方向、無一例外)。n=5 或更少時,就算 5 個樣本全部同方向,p 值最好也只能到 0.0625,永遠過不了 0.05 這個門檻。

以上就是關於 Wilcoxon 符號等級檢定的備份錄。

[REF]

  1. 什麼是「神念」?
    核心概念:神念(或稱神識)是修仙者強大靈魂力量的延伸,類似於一種高級的精神感知力。修仙者可以用它來探查四周、傳遞訊息,甚至發動精神攻擊。
  2. 什麼是「禁制」?
    功能作用:主要用於保護寶物、封鎖特定區域(如洞府、宗門重地)或限制他人行動。
    觸發後果:未經允許強行闖入或破解,會觸發禁制,輕則發出警訊、將人彈開,重則釋放強大攻擊(如神雷、烈火)將入侵者消滅。
  3. Frank Wilcoxon(1892年—1965年),是一位美國的統計學家和化學家。他在 1945 年提出了著名的非參數統計驗證方法,包括 “符號等級檢定" (Wilcoxon signed-rank test)與 “等級和檢驗" (Wilcoxon rank-sum test)。
  4. 常數的由來,也算一層禁制。想知道的才按 “閱讀全文"。
繼續閱讀「Wilcoxon 符號等級檢定小整理」

我讀 «真希望老師這樣教統計»

如前面幾篇所寫的, 這是兩位日本人菅民郎和土方裕子, 譯者是李佳蓉小姐.

這本書的開頭相當輕鬆, 比方說它介紹了數據的類型, 哪些是可以統計的, 哪些是不能統計的 (比方血型的平均值).

接著由淺入深, 講到如何統計算標準差, 以及統計中會遇到的誤差. 後面幾章還講到了如何設計與解讀問卷.

以牙醫診所的滿意度為例, 我們可以用問卷問各種問題, 並且計算出一個綜合評價. 假如某個項目的分數與綜合評價的相關係數高, 那麼就表示這個是客戶所特別重視的. 此為分析圖的 X 軸. 而 Y 軸就是各個單項的滿意度.

顯然, 待改進的項目落在右下角的區域. 它與綜合評價相關, 而單項滿意度又偏低.

最後本書教大家用 Excel 實做簡單的統計函數, 以及複雜的多變量分析. 我跟著做了一遍以免以後就懶了~~~ 這本是很不錯的書!

樣本比率的統計

前次提到取樣的比例太低時, 樣本誤差需要做修正. 當時的隨機變數是一個數字, 所以它有平均值的概念. 那麼隨機變數如果是一個比例呢? 例如紅豆在八寶粥當中的比例是多少? 所有的紅豆集合起來才能貢獻出一個隨機變數, 因此就沒辦法算出平均值或標準差了.

此時, 我們假設樣本數 n, 樣本中呈現的比率 p, 樣本誤差 D. 那麼在母體當中的比率, 可以用 p ± D 來表示. 而書上說 D = 1.96 x sqrt (p(1-p)/n).

換言之, 若我們舀了一匙的八寶粥, 裡面全都是紅豆, 或是半顆紅豆都沒有; 則 p(1-p) 肯定是 0, 樣本誤差 D = 0. 這表示我們就得相信我們買到的七寶粥 (少了紅豆), 或是一寶粥 (只有紅豆). Well, 這好像是公式的 bug.

它的理論可以從這裡找到支持. 假設標準差為 µ, 它的平方為變異數 v. 書上說:

換言之, 不要把 p 看做單一的值, 而是一個二值化 (0 or 1) 數列, 一種類型數據, 的平均值的話. (1-p) x p 就像 0 與 1 在對均值 p 計算離均差. 而變異數 v 又是離均方差的平方和的期望值 (平均值). 因此兩者的確很類似.

當然, 上次講到的修正值在比率分析中也是有效的. K = sqrt((N-n)/(N-1), N 表示母體的全部樣本數.

我還漏掉一個東西沒寫, 那就是精確度 (相對誤差), 它等於樣本誤差除以 p (比率) 或是上次的 m (平均值). 個人覺得相對誤差的意義不大, 理論基礎以後再討論.

了解了樣本誤差之後, 當我們再看到政策的支持度由 33%, 降到 27%, 再降到 25% 的時候, 要記得把每個數字都加減樣本誤差, 以得到一個 “母體比率信賴區間".

如果三次民調的信賴區間是重疊的, 那麼我們可以認為三次民調的意義沒有差別. 如果兩次民調和另外一次民調的信賴區間沒有重疊, 那麼它的效力就等於兩次有效的民調. 若三次都沒有重疊, 那麼支持度就真的持續下降了.

以上整理自 “真希望老師這樣教統計".

如何利用樣本做估計

假設我想知道整家公司的平均體重, 那麼只用一個部門來估計準不準呢? 答案是不準, 因為我們明明知道庶務二課或是秘書課的人都不胖, 所以據此估計出來 “滿帆商事" 的平均體重就會有點誤差. 這不需要數學好就可以知道.

反之, 如果根據一把抓起的豆子重量, 來估計一整桶豆子的重量範圍, 相對就比較準確了.

假設一把抓的豆子總共有 n = 100 顆, 平均數 m = 1g, 標準差 µ = 0.1g. 若整桶豆子約有 N = 10,000 顆, 可計算出樣本誤差 D = 1.96 x µ / sqrt(n) = 1.96 x 0.1 / 10 = 1.96 x 10⁻².

為啥是 x 1.96 呢? 因為假設重量為 N(0,1) 的常態分佈, 在 95% 的範圍內, 標準差為 1.96. 當樣本數很大, 樣本誤差趨近於 0; 反之樣本數為 0 的時候, 樣本誤差趨近於無限大. 如果只有一個樣本, 樣本誤差大約是 2 倍 (1.96 倍) 標準差.

[本圖取自 WIKI 標準差]

換言之, 我們認為那桶豆子的平均重量為 m – D ~ m + D 之間, 也就是 1 – 1.96 x 10⁻² ~1 + 1.96 x 10⁻² 或 0.9804~1.0196 g.

或曰, 怎麼和整桶豆子數量級 N 無關? 如果以井觀天, 以蠡測海, 也是用這個公式嗎? 非也, 這時候樣本誤差 D  還要乘上一個修正值 K = sqrt ((N – n) / (N – 1)).

把 Dnew 重寫一次得到Dnew = 1.96 x µ x K / sqrt (n).

直覺地說, 當 n 趨近於 N, 表示我一把已經把豆子抓光了, 那麼誤差應該修正為 K = 0 與 Dnew = 0. 因為 Dnew = 1.96 x µ x K / sqrt(n) .

如果真的由井底蛙來估計天空的大小, N >> n 將使得 K = 1. 因此我們知道 K 介於 0~1 之間,

為了抓一個手感, 我們假設 K = 0.49 的話, 則 N – n = 0.7 x (N -1), 0.3N = n – 0.7. 假設 N 和 n 都比較大, 那麼 n > 0.3N 是必須的. 也就是說, 想要讓修正值 K < 0.5, 那麼好歹得一把抓起 3 成的豆豆.   

以上整理自 “真希望老師這樣教統計".

變量之分析

和多變量分析相對的, 是較簡單的單變量分析, 線性迴歸分析即為其中的一種. 假設我們有一群 X 和一群 Y. 而兩者有這樣的線性關係:

Y = a + bX

那麼只要算出 a 和 b, 我們就可以用 X 求 Y, 或是用 Y 求 X 了. 計算 a, b 的步驟如下:

1. 計算 X 與 Y 的平均值 XY.

2. 計算 X 的離均差平方和. SUM (Xi X)2

3. 計算 Y 的離均差平方和. SUM (Yi Y)2

4. 計算 X 的離均差 x Y 的離均差的和 = 離均差交乘積

SUM ((Xi X) x (Yi Y))

5. 計算

b = 離均差交乘積 / X 的離均差平方和

= SUM ((Xi X) x (Yi Y)) / SUM (Xi X)2

a = Y – b x X

至於多變量要怎麼分析呢? 最簡單的方式就是用 Excel.

以上摘自 "真希望老師這樣教統計", 作者是菅民郎和土方裕子.