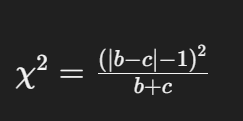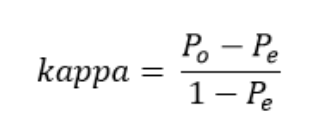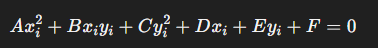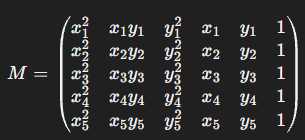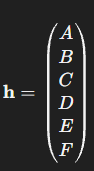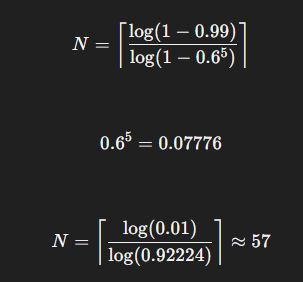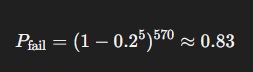2026 Q3 投資回顧

過去幾年投資賺了不少,只是每月配息的所得替代率太低了,看了很不放心。我是偏保守的人,不太能接受缺錢的時候,還要賣一些股票才有飯吃。

萬一發生 “市價急售 QQQ,在線等。" 這種畫面我不行。
過去幾年主要都是投資低配息的 QQQ,稅後殖利率才 0.43%。這次趁著從 Firstrade 搬家到 IBKR,增持了愛爾蘭版的 JEPQ.L (配美金) 和複委託的 JEPQ (配台幣)。他們有 10~11 % 左右的稅前殖利率,相當於 QQQ 的 20 多倍。特別是 JEPQ.L 是愛爾蘭註冊的版本,只需要被美國預扣 15% 的稅金,還可以免遺產稅,相當符合我的需求。經過積極地調整,這一季我總算組合出兼顧成長與穩定現金流的搭配了。

有錢就手癢是人之常情,如果還會被老美扣 40% 遺產稅那更是難以接受。所以我把海外的現金全都買光了。愛爾蘭版 QQQ (EQAC)、愛爾蘭版 JEPQ (JEPQ.L)、愛爾蘭版 0~1 年美國短債 (IB01) ,再搭配老美不扣稅的美國國債、 英國殼牌不收稅的 ADR (SHEL),這樣應該不會被剝兩層皮了。

雖然當初買 JEPQ.L 算是買錯,我以為它是累積型,不會生利息。既然買到月配版,我就在 IBKR 安排定期定額把 JEPQ.L 利息轉帳回台灣 [1][2] ([2] 有教定期匯款),基本上可作為家用。聽說有些人失業之後會去 “假裝上班公司" [3] 混時間,免得家人擔心。如果他們存夠被動收入的話,其實是可以假裝出差、實際去南極看企鵝的 (誤)。

出金最難填的欄位是 “國外代理銀行" [4],台灣稱為中轉銀行。如果 IBKR 要匯到國泰世華可以選摩根大通,匯到中國信託可以選自己在美國的分行。其他用不到的銀行我就還沒有研究。手續費跟匯款金額有關,有些收固定金額,有些賺匯差。以 Caven [2] 本人在 IBKR 的例子來說,"中轉行 (將來銀行) 就收取了手續費 USD 10,而收款行 (王道銀行) 則是收取 NT$ 200 。" 過路費多少要給一點。

目前我的規劃中:(A) 安太座的錢從美國 JEPQ.L 來,(B) 看企鵝的錢來自台股和台幣複委託的股息。(C) 美金複委託的配息,基本上就是拿來當 buffer。如果 (B) 池子還夠用,(C) 就繼續投資。萬一卡刷爆了什麼的,就把 (C) 的美金換成台幣救急。當然,我也乖乖地存了 1~2 年的生活費當定存,這就是最後一道不賣股票的防線。
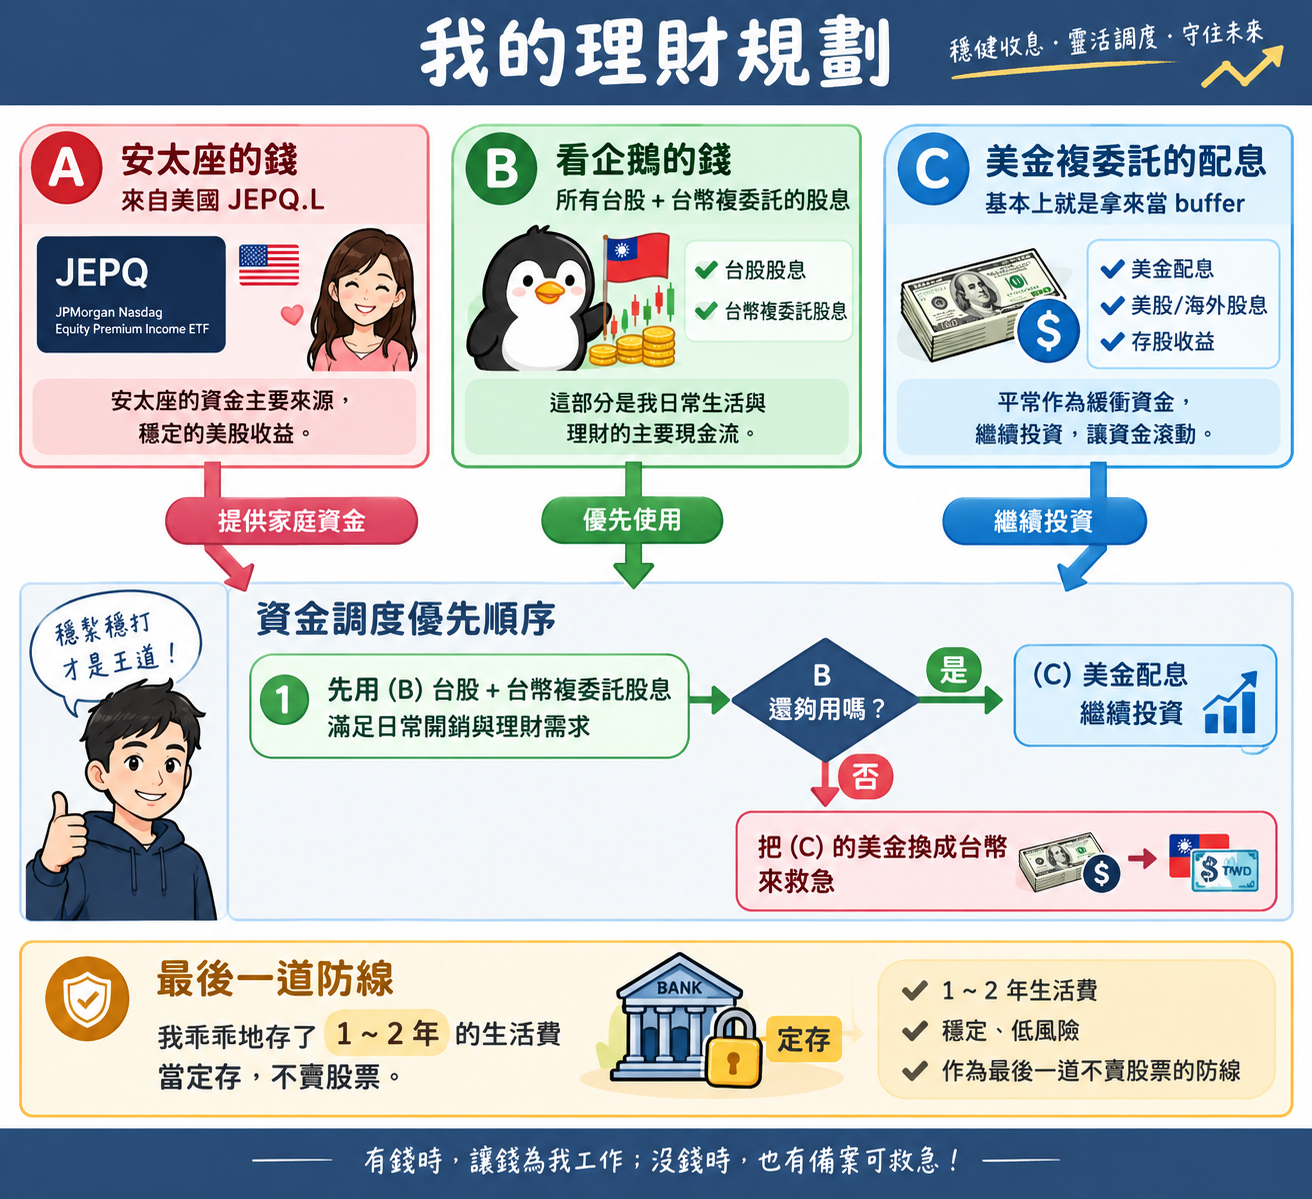
這個 ChatGPT 真的滿會畫圖的。不過,如果我教它們分析我的投資組合,每個都在叫我做 “股債平衡",屢試不爽,也令人不爽。如果我改問為何 AI 喜歡教人做股債平衡?AI 說因為這個答案比較不容易出錯。其實不同景氣環境下,股票和債券表現可能不同。所以確實可以不用太在意 “標準答案"。

環境股票債券
景氣擴張通常較好普通
景氣衰退通常較差可能較好
降息成長股與債券可能受惠通常受惠
升息股票可能波動債券價格可能下跌
高通膨股票不一定好債券也可能受傷

今年 Q1 的 QQQ 家族佔 我總投資的 48.1%,Q2 因為從 Firstrade 搬到 IBKR, 賣出 QQQ,定期定額換成愛爾蘭版的 EQAC,QQQ 占比一度降到35%。不過即使中間有所掙扎,最後還是回歸 Nasdaq-100 家族,占比回升到 47.1%。 下圖占比很小沒有數字的是日本大盤 (1475.T) 和美國以外 (VXUS) ETF。
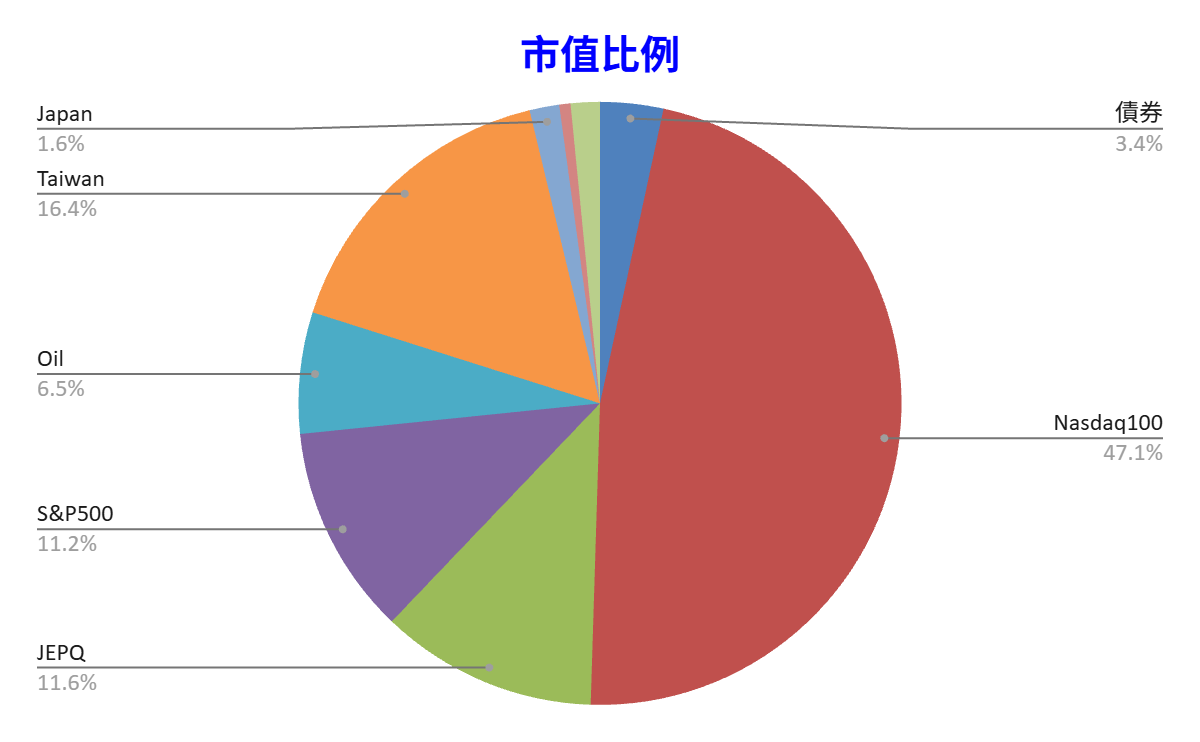
債券的部分維持不變,本來曾經想要加碼一些殖利率 5~6% 的美國長債。不過次級市場只能買到 4~5% 的價格,所以退而其次,買了 0~1 年的短債 ETF IB01,這是不配息的愛爾蘭美債 ETF。畢竟 AI 唸我不是買 QQQ、就是買變種 QQQ (JEPQ),它稍微影響了我的道心,所以拿一丁點錢買了 IB01,這是今年的新投資項目。

現在一共持有 13 檔標的,定期定額買入 0050、VXUS、SPY,金額都很小。另外就是配息後加碼買日股,以及公司強迫中獎 – 定期定額買 2379。

  • QQQ (x2) = QQQ + EQAC
  • Taiwan (x2) = 0050 + 2379
  • JEPQ (x2) = JEPQ + JEPQ.L
  • S&P500 (x1) = SPY
  • OIL (x1) = SHEL
  • 債券 (x3) = 中期美債 x 2 + IB01
  • 日本 (x1) = 1475.T
  • 美國以外 (x1) = VXUS

投資績效的話,9/30 晚上一度創新高,收盤後變成歷史次高。比起 2025 年底,年增率 28.47%。最近 7 季的成績就抵過以前很多年 (如下圖),這跟我的操作技術無關,因為問了同事的績效好像也差不多,主要是通膨和複利的效果。如果要感謝的話,主要是公司讓我日常生活無虞,放進投資帳戶的錢幾乎都不用再拿出來。還有我的老婆和小孩都很 “客家",沒花什麼錢。以及默默幫我賺錢的公司、樂觀的廣大投資人。特別是追逐短期回報的股友們,我的老人福利金 – JEPQ covered call (價外買權) 就靠你們了!

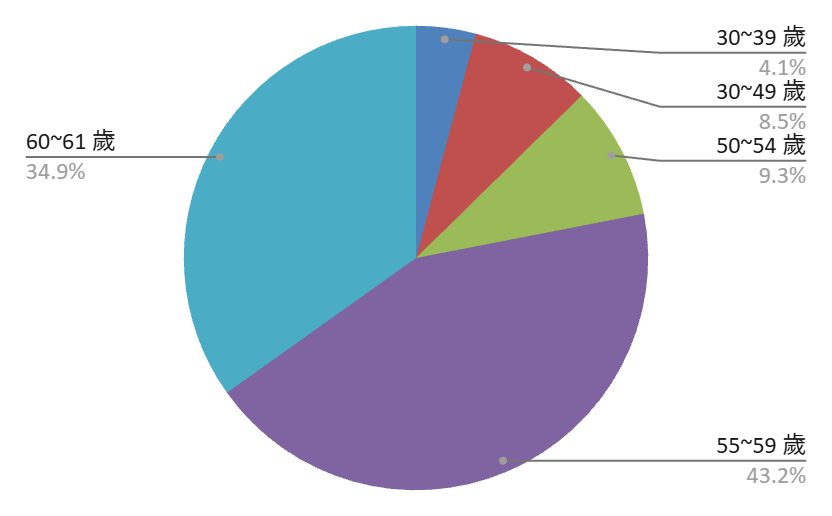
每個年齡段的獲利佔比, 20~29 歲賺的錢都付房貸了,所以忽略不計。照理說,每個投資大盤的人都會得到類似的佔比結構。
假設有一個人,20 歲月薪 X 萬,每年調薪 3%。薪水 1/3 拿去定存,定存利率 1.5%,它的圖形會長成這樣。這邊的 X 是變數,無論 X 是多少,只要 all in 定存都不影響結果。反倒是一旦調薪停滯,那格就只會比前一格稍大一點點而已。
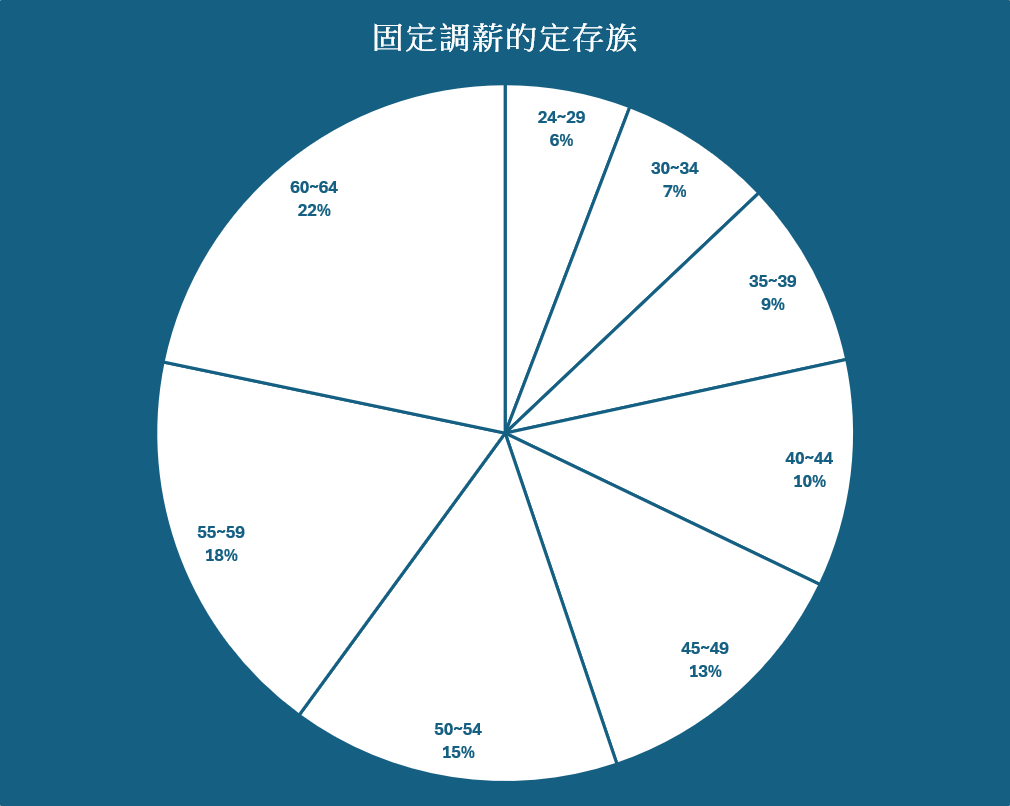
這邊的定存利率 1.5%, 如果改成殖利率 Y%,Y 愈大就會愈接近我的分布圖。雖然我近 20 年的年化報酬率是 15.58%,但早年多是靠薪水挹注,直到業外收入大於本業收入 N 倍才算財務獨立。交大校訓:飲水思源,賺錢都是要感謝螃蟹、蟹老闆。

[REF]
  1. IB盈透證券出金教學-如何把資金匯回銀行?(流程圖解、電匯手續費) – Mr.Market市場先生
  2. 2026 IB 出金教學│盈透證券電匯回台、手續費與到帳時間一次看-Caven投資成長家
  3. 假裝上班公司
  4. https://aspireapp.com/zh-HK/blog/what-is-an-intermediary-bank

道友,報上名來

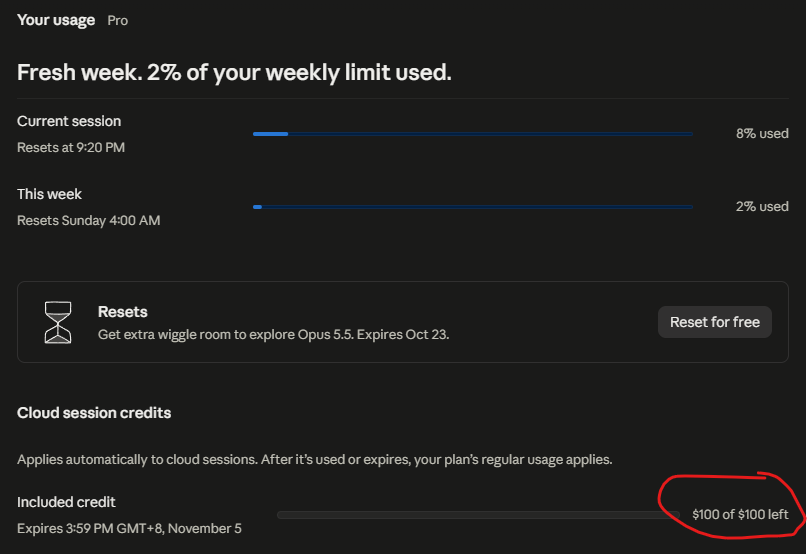
Antropic Claude 這幾天有一個福利,就是 Pro、Max 的用戶,可以申請 100 或 250 USD 的 credit。除了從終端機 CLI 打 “/claim-credit" 申請、也可以直接用 http://claude.ai/code [1]。我是用網路版申請。瀏覽器內點左下角頭像、然後選 Setting、Usage 這種方式。總之按下 “claim-credit" 就有 100 USD,不拿白不拿,10/7 前領取。

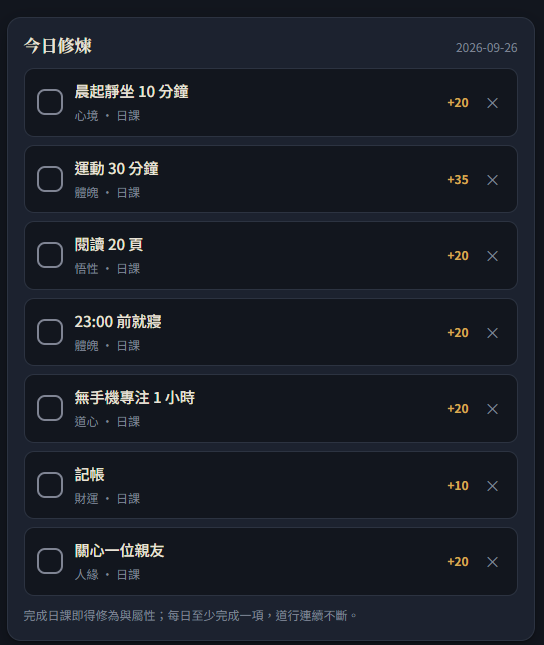
這個福利有使用期限,只到 11 /5。下午我靈機一動,就用 Fable 做了這個 APP。主要是參考 Liferest [2],把自我提升當作 RPG 遊戲。介面當然是繁體中文,等級當然也是中式的修仙等級,搭配神話 (Fable) 剛好而已。

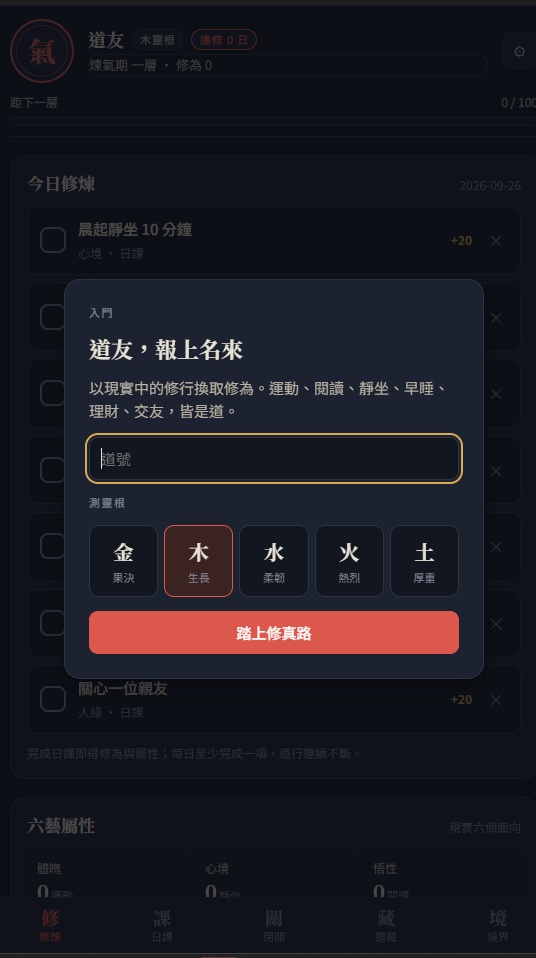
鍛鍊的內容像是這樣。認真改良的話,還可以修五靈根、體修、…。

總之 Claude 聽懂我簡短的需求,沒幾分鐘就做好了這個,還有 README。.笑死人了!

九大境界共 46 層:煉氣一~九層;築基到大乘各分初期/中期/後期/圓滿;渡劫分一~九重雷劫。每層所需修為 = 100 × 1.16^層數,滿了按「突破」,跨境界時觸發天劫畫面,渡完九重雷劫則飛升。

六藝屬性對應現實六面向:體魄、心境、悟性、道心、人緣、財運。

五個分頁:修煉(今日日課、屬性、突破、紀錄、連修天數)、日課(每日重置的日課+一次性機緣任務,可自訂難度)、閉關(15/25/45/60 分專注計時,每分鐘 1 修為)、道藏(每日心得+心境標記)、境界(46 層總覽)。設定裡可改道號、複製/匯入 JSON 備份、重修。

我第一步我請它做網頁版,第二步才是打包 Android APP。而且從這邊開始,我把 Fable 降級到 Sonnect。

我來做 Android 版:用原生 WebView 殼(Kotlin + Gradle)包住現有的 App,並加上 GitHub Actions 自動編 APK;同時把網頁版加上 PWA 設定,手機瀏覽器可直接「加到主畫面」。先看這裡有沒有能編 APK 的環境。

Android 版做好了,兩種形式都有:

1. 原生 Android APP(android/)

  • Kotlin WebView 殼,載入同一份 index.html(編譯時自動從專案根目錄複製進 assets,網頁版改了 App 就跟著改)。
  • 套件名 com.lifereset.xiuzhen、Android 7.0+;用 WebViewAssetLoader 給 localStorage 固定 origin,修為資料不會遺失;跟隨系統深色模式;返回鍵、外部連結、鍵盤 inset 都處理了。
  • App icon 是朱砂「氣」字印(adaptive icon + 各 dpi 的傳統 icon)。

2. PWA

  • 加了 web/manifest.webmanifest、sw.js 離線快取與 icon;放上 GitHub Pages 後,手機 Chrome「加到主畫面」就是獨立視窗的 App,不裝 APK 也能用。

Claude CLI 反而不像 Antigravity 那樣會自動幫忙下載 Android Studio。所以這邊是用 GitHub Actions workflow [3],Claude 再幫忙加個 .github/workflows/android.yml。然後我把 code push 上 Github,Github Actions 分頁的「Build Android APK」跑完就能下載 APK [4]。可能有 bug,但是 Android 安裝程式掃過無毒。很好奇的話可以安裝在 Android 開發板上。

結果,這題難度太低了。根本沒燒到那 100 USD。這兩天再想想。

[REF]

  1. https://www.threads.com/share/Fwl8NnuVj/
  2. https://www.lifereset.com/
  3. https://github.com/apps/claude/installations/select_target
  4. https://github.com/ufocash16785/liferest/actions/runs/36242519954/artifacts/10906776662

BH-FDR 小筆記

BH 代表這是 Benjamini 和Hochberg 這兩個人提出的一種統計方法。FDR 表示 false discovery rate,顧名思義,這個方法用來檢測偽陽性率。

它計算的對象不是原始數據,而是顯著性檢定時的那個 p。本來在 p < 5% 時就判定有顯著性。但其中也可能有偽陽性的存在,所以要再多做一個 BH-FDR 把它揪出來。

假設你做了 6 次檢定,得到這些 p 值,乍看之下有五個顯著,C 不顯著,E = 0.049,剛好在邊緣,看了有點不放心,那就適合 BH-FDR。先看簡單的臨界值法。

檢定原始 p 值
A0.021
B0.004
C0.130
D0.018
E0.049
F0.001

我們設定 “假發現率水準":α=0.05

總檢定數:m=6

第 1 步:把 p 值由小到大排序

排序後:

排名 ip 值 pi​對應原檢定
10.001F
20.004B
30.018D
40.021A
50.049E
60.130C

第 2 步:計算每個排名的 BH 臨界值

公式是:imα

因為 m=6、α=0.05,所以:

排名 ip 值 pi​BH 臨界值 i6×0.05
10.0010.0083
20.0040.0167
30.0180.0250
40.0210.0333
50.0490.0417
60.1300.0500

第 3 步:找最大的 i,使得

pi≤imα逐一比較:

  • 0.001≤0.00830.001≤0.0083,成立
  • 0.004≤0.01670.004≤0.0167,成立
  • 0.018≤0.02500.018≤0.0250,成立
  • 0.021≤0.03330.021≤0.0333,成立
  • 0.049≤0.04170.049≤0.0417,不成立
  • 0.130≤0.05000.130≤0.0500,不成立

所以最大的符合者是:i=4


第 4 步:判定顯著結果

BH 方法會把 排名 1 到 4 的檢定都視為顯著。

所以顯著的檢定是:

  • F
  • B
  • D
  • A

不顯著的是:

  • E
  • C

由於 p 值這種東西不能看平均值,也無法正規化,所以用排名來解決。假如不喜歡排名,也有純計算的方法,方法二就是計算 q 值。

q 值的定義:qᵢ = pᵢ × m / i(m=檢定總數 6,i=該 p 在排序中的排名),利用前面排好的順序,代公式算出 q。

步驟 1:算原始 qi
原始 p 值原始 q
0.001 q = p×6/1: 0.0060
0.004q = p×6/2: 0.0120
0.018q = p×6/3: 0.0360
0.021 q = p×6/4: 0.03155
0.049q = p×6/5: 0.0588
0.130q = p×6/6: 0.1300
步驟 2:單調化(關鍵!)

q 必須隨排名單調遞增,所以從最後往前取累積最小值,方向和方法一相反:

qi 值BH 校正後的 q
q₆ = 0.1300
q₅ = min(0.0588, 0.1300) 0.0588
q₄ = min(0.0315, 0.0588)0.0315
q₃ = min(0.0360, 0.0315)0.0315 (同上)
q₂ = min(0.0120, 0.0315)0.0120
q₁ = min(0.0060, 0.0120)0.0060
步驟 3:用 q < 0.05 篩選
  • p1: 0.001 ,q = 0.006 < 0.05 ,成立
  • p2: 0.004 • q = 0.0120 <0.05,成立
  • p3: 0.018 • q = 0.0315 <0.05,成立
  • p4: 0.021 • q = 0.0315 <0.05,成立
  • p5: 0.049 • q = 0.0588 <0.05,不成立
  • p6: 0.049 • q = 0.1300 <0.05,不成立

結果和方法一是一樣的。為什麼要做這件事呢?假如今天我要做很多次檢定,例如跑 10 種 LLM model 測試 5 種演算法,一共跑了 50 組。每一組信心程度都是 95%。那麼在這麼多測試當中,有 1−(0.95)50 ≈ 92.3% 的機率產生一次歪打正著,結果和其他人相反。但你不能拿這一組數據證明什麼天大的發現?除非你經過了 BH-FDR 測試後,它仍然是顯著。

McNemar 精確檢定小筆記

這又是一種檢測顯著性的方法。上次已經提過 Wilcoxon 符號等級檢定, 這次擴充到 McNemar 檢定。世足賽過去沒多久,McNemar 令我聯想到巴西的內馬爾 (Neymar),但是少了一個 Y。 兩者沒有關係。至於 Mc 開頭的人名,在蓋爾語(蘇格蘭和愛爾蘭),意思是「…的兒子」或「…的孩子」。

Wilcoxon (藍色) 和 NcNemar (紅色) 在下表中,可以看出他們都是處理相依樣本 (使用前、使用後);最大差異是 Wilcoxon 處理連續資料,McNemar 處理類別資料。至於獨立樣本那部分,現在還不在我的 study 雷達範圍。我沒有要改行做統計,所以暫時不會去研究。

資料類型資料分佈 / 特徵獨立樣本
(
兩組不同的人)
配對 / 相依樣本
(
同一組人前後測)
連續型資料
(如:身高、分數)
符合常態分配
(有母數檢定)
獨立樣本 t 檢定獨立樣本 t 檢定
非常態 / 順序尺度
(無母數檢定)
曼-惠特尼 U 檢定
(Mann-Whitney U)
或稱 Wilcoxon 秩和檢定
Wilcoxon 符號等級檢定
(Wilcoxon Signed-Rank)
類別型資料
(如:是/否、過關/淘汰)
計數 / 比例分佈卡方同質性檢定
(或卡方獨立性檢定)
McNemar 檢定

相較於 Cohen’s Kappa 同時考慮相同、不同的分類,McNemar test 只看不同的。假設有考生參加第一次模擬考試後,跑去參加了魔鬼衝刺班,然後又拿一樣的考卷再考一次。

前測 \ 後測答對答錯合計
答對15318
答錯121022
合計271340

我們忽略掉本來就會的 (15 題)、還有補了也不會的 (10 題),專門看有差異的部分;也就是 “對變錯" 的 3 題 (參數 b),和 “錯變對" 的 12 題 (參數 c)。對變錯可能是粗心、或是沒有訂正的習慣,看到題目就想起錯的答案…等等。

把 b、c 帶入 Mcnemar test 公式,計算 X。

χ2 = (|3-12|-1)2 / (3+12) = 64 / 15 ​≈ 4.27

這個值服從自由度為 1 的卡方分配,查表可以得到 p≈0.039 < 5%,所以表示顯著。也就是補習有用!

當考試題目不是 40 題,而是只有 10 題的話。那麼 b、c 的值可能很小,這樣算出的 x 會顯得不夠可靠。例如:

前測 \ 後測答對答錯合計
答對303
答錯617
合計9110

帶公式 χ2 = (|0-6|-1)2 / (0+6) = 25 / 6 ​≈ 4.17,查表 p≈0.041,雖然 0.041 還是小於 5%,但是慢慢逼近門檻值了。明明進步了 6 題,而且沒有任何一題 “對變錯",我們直覺這個補習很有用,但是數字不漂亮。

這個時候,我們該用的是精確測試。我們現在變化的有 6 題,全部都是變好。假設跟擲骰子一樣,擲出 6 個雙數的機率 p = (1/2)6 = 0.015625。在另外一方向上 (對變錯),同樣是擲出 6 個單數,機率一樣。兩邊機率相加,p=P(X=6)+P(X=0)=641​+641​=642​=0.03125。

p=0.03125<0.05 比 0.041 還要明顯,所以數字小的時候,適合做 McNemar exact test。

Exact test 不只 McNemar 這一家開張,在兩組獨立樣本時,我們會用 Fisher’s exact test。萬能的天神保佑,我不會需要研究它!

[REF]

Cohen’s Kappa 和 RANSAC

這是兩個關鍵字類似的名詞,前者和 “隨機期望一致" 有關,後者和 “隨機抽樣一致" 有關。先講前者。

假設有兩個法官,一個是公職的法官 A,一個是國民法官 B。我們知道即使九位國民法官意見都一樣,但三位公職法官意見不一樣時,被告都是可教化的,所以我們只各找一位來當例子就好。這兩位法官剛好同時參加過 100 場審判,判決結果如下:

國民法官 B: 有罪國民法管 B: 無罪總和
法官 A: 有罪 60565
法官 A: 無罪102535
總和7030100

Kappa 的公式如下,有時簡稱 K 值:

其中,Po 是兩個法官都有共識的比例,Pe 是兩個法官做出相同判定的期望值。

P0 = (60+25) /100 = 85% (兩個對角線粗體)

Pe = 65/100 * 35/100 + 70/100 * 30/100 = 0.65 * 0.35 + 0.7 * 0.3 = 0.2275 + 0.21 = 0.5475 (紅配紅 + 藍配藍)

Kappa = (0.85 – 0.5475) / (1 – 0.5475) = 0.3025 / 0.4525 = 66.85%

這個值好嗎?

Kappa (k 值)意義
<0.20幾乎沒有共識
0.21–0.40尚可 (fair)
0.41–0.60中等 (moderate)
0.61–0.80高度共識 (substantial)
81–1.00幾乎完全一致

它的數學意義是:Pe 代表雙方意見一致的機率。Po 只是表示有多少比例意見一樣。看似是一樣的東西,但是假設公職法官 A 其實一律都喜歡判無罪,即使國民法官 B 只會判二成無罪,雙方理念根本不同,只是恰好有 20% 結果相似。此時 Po 還是有 20%。而 Pe = 0 + 0.2 = 0.2 = P0,Kappa 直接就歸零了。也就是說 Kappa 抹除了恰好答案一樣的機率。

國民法官 B: 有罪國民法管 B: 無罪總和
法官 A: 有罪000
法官 A: 無罪8020100
總和8020100

我們也可以推廣到是非題考試,甲生每一題都選 O,乙生靠轉公正的筆作答。結果兩人答案有 50% 一樣 (P0 = 50%),兩生有五成作弊的嫌疑…. 嗎?看 Pe (隨機期望一致) 就知道沒有作弊。


至於 RANSAC (RANdom SAmple Consensus) [1] 和 “隨機抽樣一致" 有關。顧名思義,隨機抽樣會抽好幾次。假設我們去夜市玩,遊戲是從摸彩箱中抽出乒乓球,抽中紅色有獎,抽中白色摃龜,抽完球要放回去。箱子裡總共有 100 顆球,其中有獎的機率是 {\displaystyle w}。我的玩法是一把抓 n 顆球,然後預算足夠玩 k 次。

如果我一把抓 n 顆球全部中獎,機率顯然是 {\displaystyle w^{n}} 。至少有一顆沒中 (白球) 的機率是 1-{\displaystyle w^{n}} 。K 次嘗試後,每次都至少有一顆白球的機率是 ( 1-{\displaystyle w^{n}})k。假設我的目標是,不管玩幾次,有一把全紅才叫做成功,假設這機率是 p,失敗率就是 1 – p。

1 – p = ( 1-{\displaystyle w^{n}})k

{\displaystyle k={\frac {\log(1-p)}{\log(1-w^{n})}}}

這裡的 k 和 Kappa 的 k 顯然是兩回事。這個公式告訴我們,目標愈大 (n 大),通常要嘗試愈多次 (k)。想成功 (p 大),也要嘗試愈多次 (k 大)。挑戰的題目很大 (w 小),還是要嘗試很多次。雖然都是要嘗試,至少我們知道 w,決定 n 之後,大致能知道 k 和 p 的關係。

Ransack 的中文意思是「洗劫」、「掠奪」或「翻箱倒櫃地徹底搜查」。RANSAC 比較正面,這個演算法是用來從一群有雜訊 (離群值) 的數據中,歸納出最多證據支持的數學模型 (可以是高維度,但通常只看到二維的例子)。

我們猜的模型可能需要 n 個點才畫得出來 – 直線只要兩點 (n = 2),雙曲線可能要 5 個點。假設,為了猜這些點是否能用雙曲線模型來模擬,我們需要先一把抓 5 點 (x1​,y1​),…,(x5​,y5​),看它能不能連成雙曲線?

它可以寫成矩陣 Mh=0,其中

這個模型有 A、B、C、D、E、F 共6 個係數,但只差一個比例因子,所以自由度是 5。只要看 B2 − 4AC > 0 成不成立?就知道基本像不像雙曲線?(先忽略退化檢查,嗚嗚嗚,難怪大家都愛舉直線為例。)如果看起來不像雙曲線,就再抓一把 5 個點來評估。

評估方法是把 “所有點" 都對雙曲線模型計算殘差 (測量距離方法可彈性選擇)。如果這個模型正確,顯然會有更多的點落在這條虛擬的雙曲線上。至於那些沒抓的點算不算是在模型之內?就要看誤差大小。若殘差小於門檻 τ,就當成 inlier (內點),反之是 outlier (離群值)。我們數數這次總共有多少點是內點?記下來找最大值。最後選出抓到最多內點的那個組合就是候選最佳模型。

我們考慮雙曲線模型的話,第一個變數就定下來,n = 5。接著我們還要對資料的品質有點手感,w 是內點的比例;假設這次是估 60% – 100 個點中有 60 個內點,40 個離群值。我希望成功率 99%,那麼至少應該嘗試抓幾次呢?根據前面公式的變化形態:

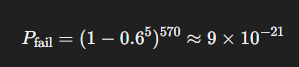
大約要跑 57 次 RANSAC iteration,才有 99% 信心至少一次抽到全內點的 5 點樣本,也就是可以直接畫出雙曲線。才試 10 次不用放棄!反之,那試了 570 次都失敗,是否模型一定猜錯呢?AI 很客觀地說,什麼事都有可能?模型猜錯只是其中一種可能,儘管模型正確的機率極低。

更有可能是資料很髒,w = 0.2,80% 的資料都是雜訊。那失敗 570 次也很正常,機率高達 83%。

總之,RANSAC 提供了一種客觀的評估邏輯。細看公式就會發現,一次抓 10 點又全對的機率反而比較小,導致要抓更多次才會過關。因此在嘗試階段只會抓 minimum 點數,到最後要修飾模型時,才會抓更大把的內點來調整模型的參數。

[REF]

  1. 隨機抽樣一致