RRF 小筆記

此處的 RRF 是指 Reciprocal Rank Fusion,中文叫做倒數排名融合。第一個關鍵字是倒數,不是ㄉㄠ \ㄕㄨ V ,是 ㄉㄠ V ㄕㄨ \ ,誰的倒數呢? 這就是第二個關鍵字 – 排名的倒數,跟上次的 Wilcoxom 一樣,排名是個最簡單的指標,不用量化,最小的就是 1,然後愈來愈大,至少平手。

第三個關鍵字是融合,表示可以用多種方式排名,然後混在一起算。當然,這就有可能要給不同的方法一個權重。對於所有排名清單集合 R,某個排名清單編號 r ,文件 d 的 RRF(d) 分數如下。其中 k 是一個正值的常數,用來使排名第一和第二的差異不要太懸殊。另一方面,這個值會使得排名在後面的 d 們,RRF (d) 看起來也都差不多,故稱為平滑常數。
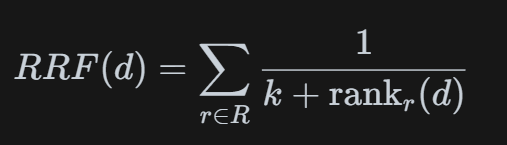
那為何不把一種排名做好,要拿一堆排名來融合呢?這個跟基測、會考、聯考一樣,取的是通才。如果只看少數指標,那就是指考了。也沒有不行,就看是哪種應用。有些學校比較看重特定科目,就可以個別給加權分數。
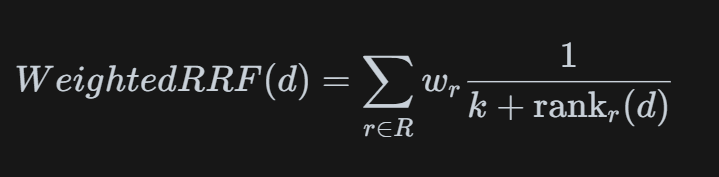
舉例來說,我們希望從 RAG 中找出與使用者提問最相關的資料。然而,「相關」或「相似」本來就沒有唯一的判斷標準,因此我們不侷限於單一檢索方式,而是同時採用 BM25、向量檢索(Vector Retrieval)、Metadata Retrieval 與 Graph Retrieval 等多種策略,再整合各自的搜尋結果。
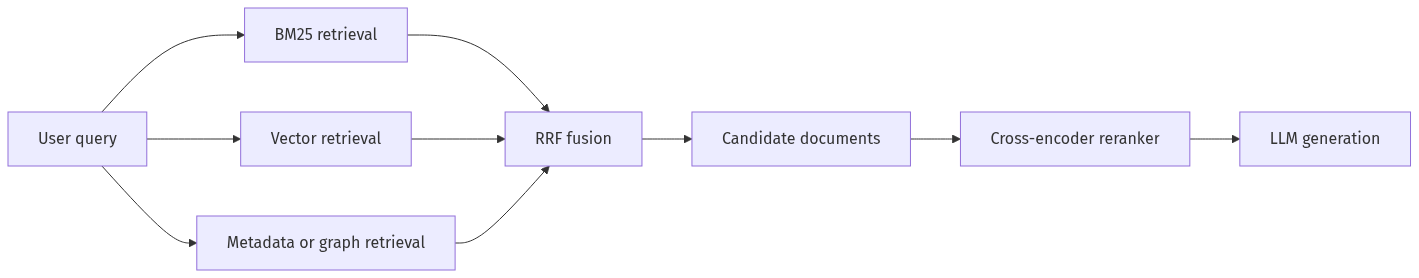
Vector Retrieval 是最常見的做法:先將問題與資料轉換成 embedding vectors,比較它們在向量空間中的距離,取回相似度最高的前 5 或前 10 筆資料,再將對應文字放入 prompt 的 context window。

Graph Retrieval 則是將資料整理成圖譜結構,利用實體與實體之間的關聯進行檢索,因而能找出僅靠語意相似度不容易發現的關聯性資訊。

Metadata Retrieval 主要透過人名、地名、日期、產品型號等結構化欄位進行精確篩選。

最後,我們可以透過 Reciprocal Rank Fusion(RRF),將不同檢索器產生的排名結果融合成一份候選清單,再選出最適合放入 context window 的內容。

咦?怎麼少講一個 BM25?因為這個比較不直覺。它算是 TF-IDF 的擴展。所以我們先看TF-IDF, 這個名詞同樣要拆解。

詞頻(Term Frequency, TF):計算關鍵字在單一文件內出現的次數。
逆文件頻率(Inverse Document Frequency, IDF):衡量關鍵字在整個文件庫中的罕見程度。越稀有的詞彙權重越高,像「的」這類高頻停用字權重則接近零。

兩個東西乘在一起就是,這個詞比較罕見,又出現很多次,那就是重要。
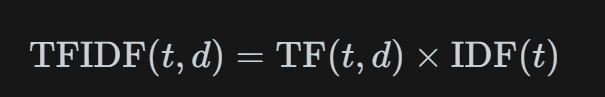
其中,f(t,d) 表示詞 t 在文件 d 中出現的次數。最基本的 TF 可以直接定義為 TF(t,d) = f(t,d)。至於 IDF(t) 可以表示為:
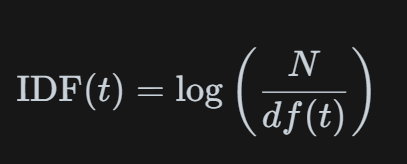
假設資料庫中共有 N 份文件,df(t) 則表示其中有多少份文件包含詞 t。需要注意 df(t) 計算的是文件數量,而不是詞 t 在所有文件中的總出現次數。TF(t,d) 和 IDF(t) 都有不同的變形。例如,可以對 TF 使用對數縮放,避免詞頻增加時權重無限制地成長;IDF 則常加入平滑項,以避免除以零,並讓數值表現更加穩定。

那麼 BM25 又是什麼呢?BM25 是資訊檢索系統中很常用的文件排名函數。它與 TF-IDF 使用相似的核心訊號,也就是詞頻逆文件頻率;但嚴格來說,BM25 源自機率檢索模型,並不是 TF-IDF 的特例。

看公式,我們可以發現它引入 k1 讓曲線更平滑。然後不只考慮一個單詞 t,而是使用者查詢 ( 如:prompt) q 裡面的所有 t 都加在一起。因為全部相加,右邊的分子分母都有 f(t,d),故我們預期這一項會飽和。
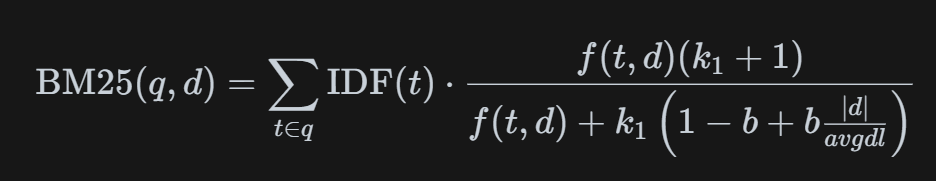
那麼分母的 b、d、avgdl 是怎麼回事呢?

我們回顧一下本來要做什麼事?我們是用一個查詢句 query q,去資料庫的一堆 data d,想要找出前幾名相關的文件。而文件中不同的 d 有長有短,不同文件的長度可能差異很大。長文件因為包含的詞較多,自然也更容易命中查詢關鍵字。

相反地,若同一個詞在一份短文件與一份長文件中出現相同次數,它在短文件中的集中程度通常更高。所以文件 d 的長度 |d| / 平均 d 的長度 (avgdl = average data length),也可以反映重要性。如果都一樣長,那麼 |d|/avgdl = 1,1 – b + b = 1,分母就更簡化了。

另外 b 就可以單獨控制要不要考慮文件長度:

  • b=0:完全不考慮文件長度
  • b=1:完整依照文件長度比例進行正規化
  • 0<b<1:在不正規化與完整正規化之間折衷

公式講完了,最後來正名。BM25 的 25 是版本編號,BM 是 best match。它是由 Okapi 資訊檢索系統所發展的一系列 Best Match 排名函數之一,就算只取 top 5,公式還是叫 BM25。
RAG with FAISS

RAG (Retrieval-Augmented Generation) 大家應該都知道了。至於 FAISS 是 Facebook AI Research(FAIR)開發的技術,主要用途是對海量高維度的資料作出相似度的比較。由於我是第一次看到 RAG 和 FAISS (Facebook AI Similarity Search) 一起用,所以做個筆記。

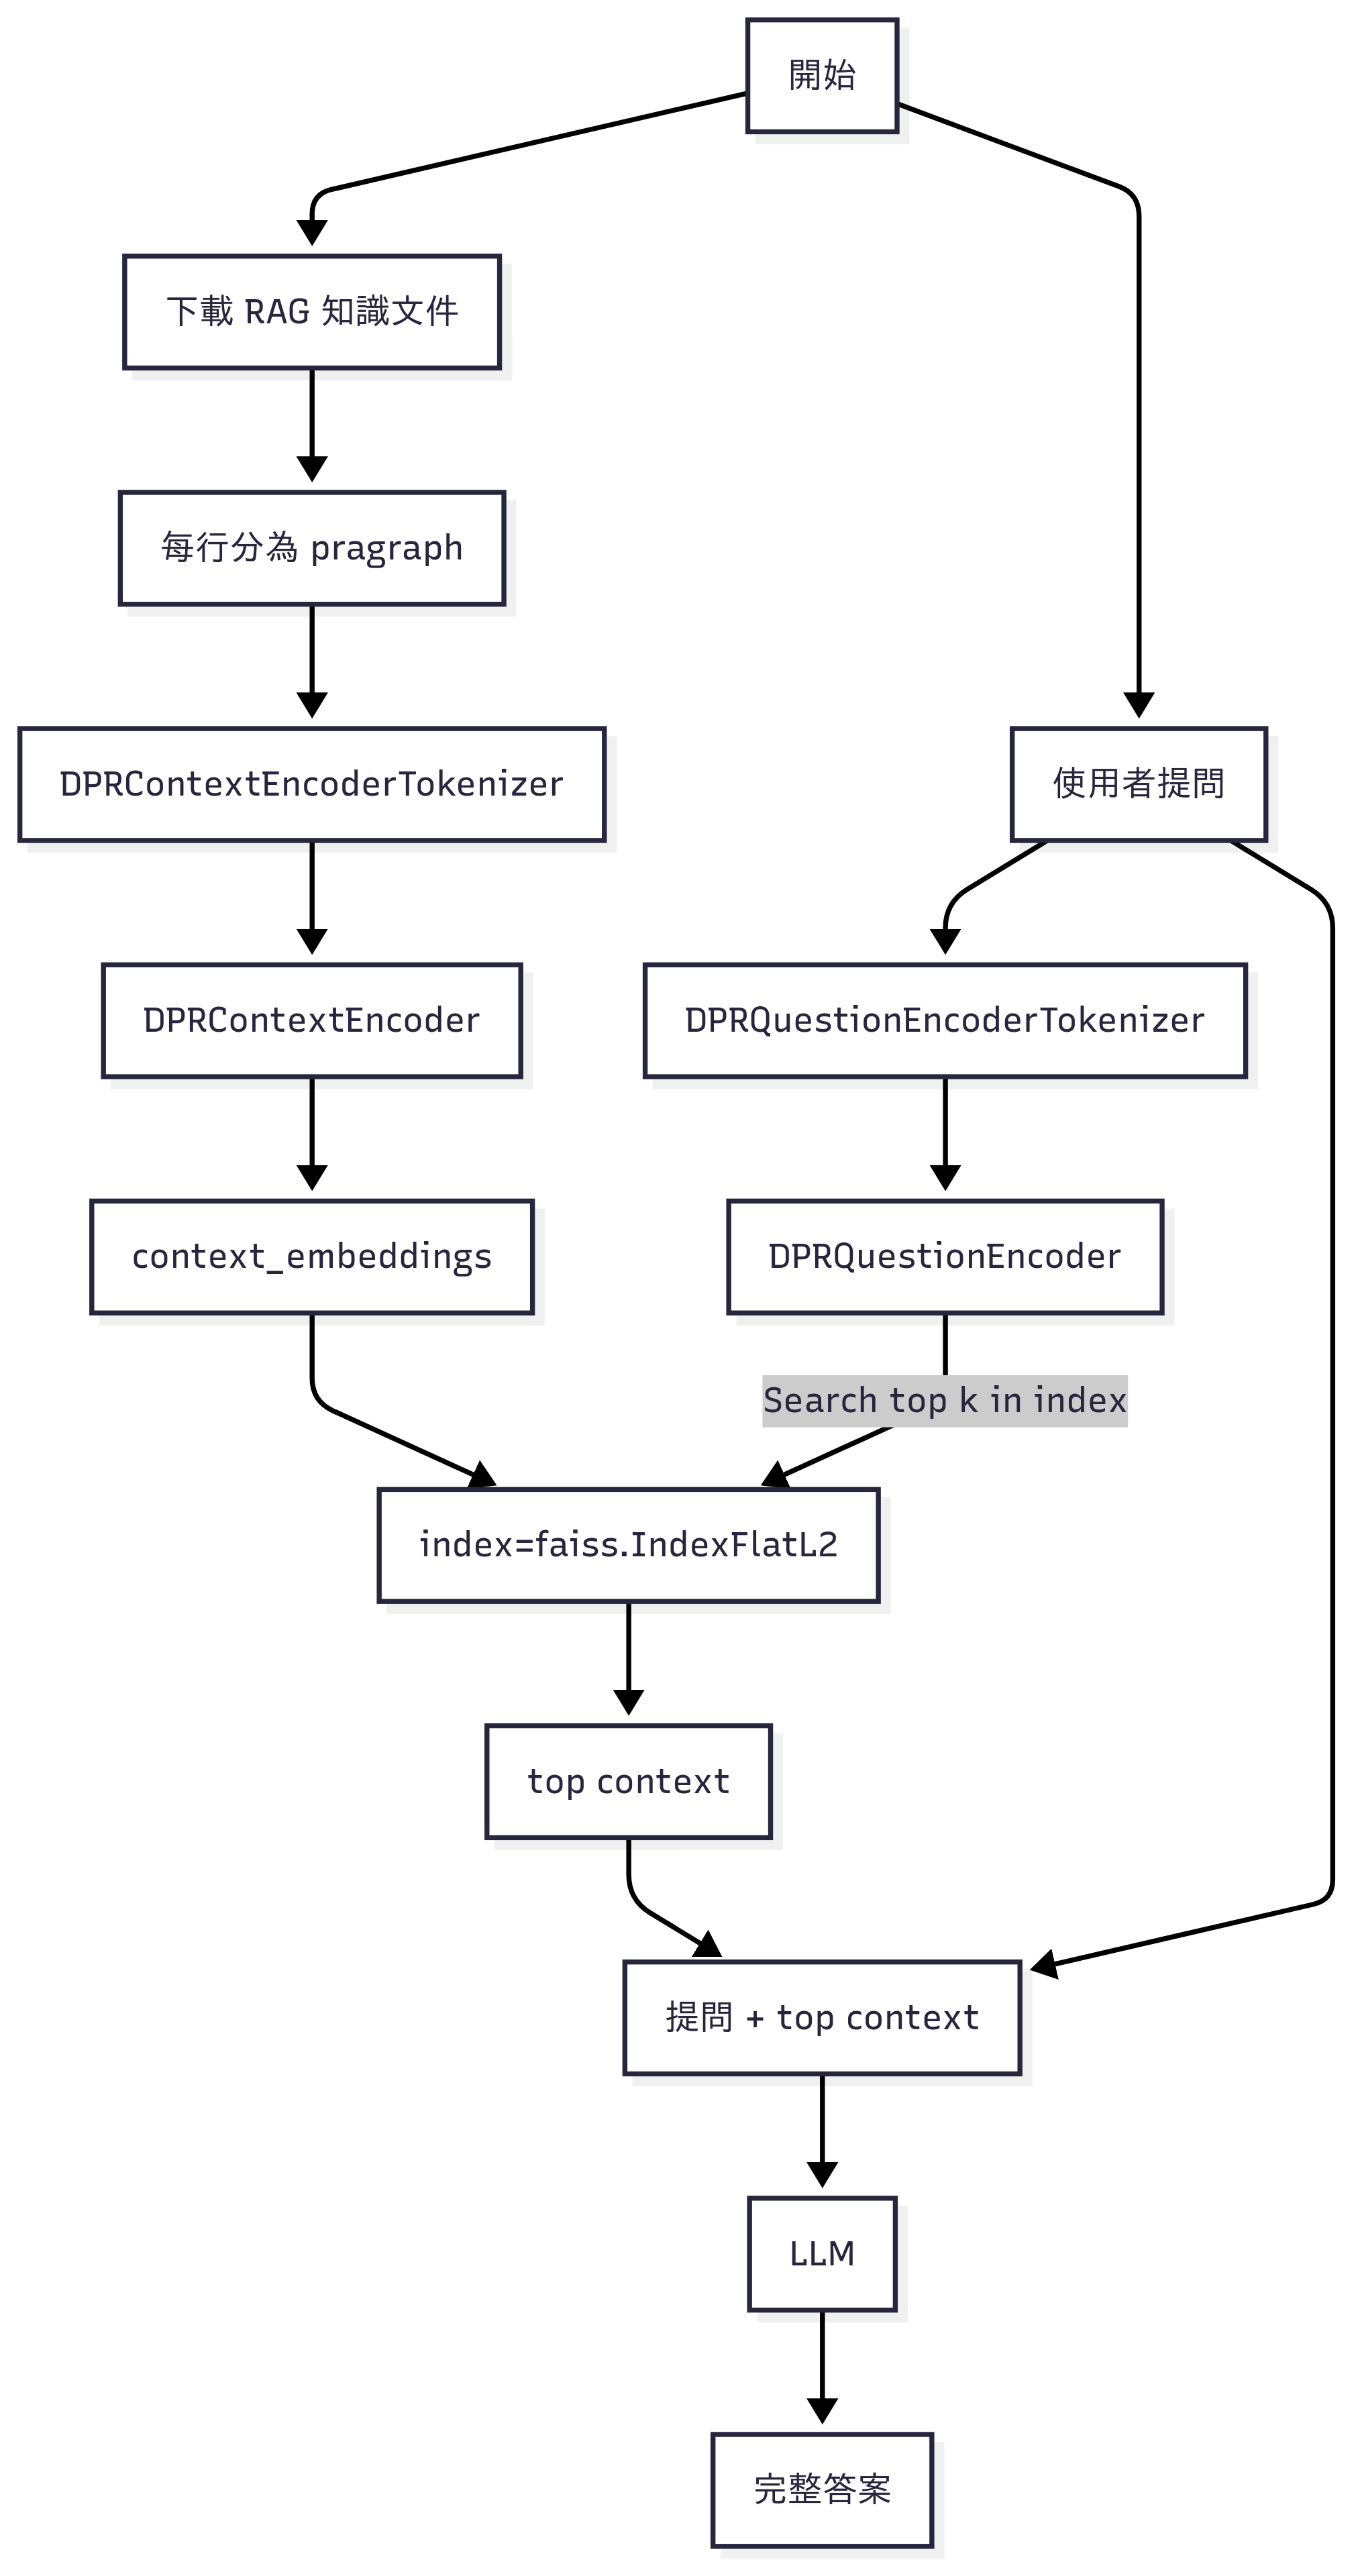
基本上 RAG 的知識庫可能是一本書、一本使用手冊、一堆 Facebook 的用戶資料等等。它們先分為不同的小段落,然後 tokenize,每個段落再 encode 為一個向量。同理,對使用者提問也做同樣的事,但此處理解為只產生一個向量。

由於知識庫的向量筆數很多, FAISS 為他們製作 Index。提問的向量用 FAISS 的函數中找出最接近的幾筆最相關的向量,再根據 index 反查出 text 原文。然後把 text 和使用者提問合在一起去問 LLM。

對 LLM 來說,它可以有自己的 tokenizer。總之,RAG 已經功成身退了。

假如不用 FAISS,純靠 Pytorch 的話,那麼要自己用 dot product 去比較相似性。因為每個 word 就可能對應到一個高維的 token,所以每個 pragraph 的向量就是所有組成 pragraph 的 word 的向量的平均值。

最後補充 DPR (Dense Passage Retriever)。顯然,它對於 question 和 context (passage) 用了兩套函數 – 所謂 dual encoder [1]。我們可以想像,對於 question 的編碼應該要力求精準,但是對於參考文件這部分,如果是一本百科全書、或是整個資料庫,那編碼時主要是求快!所以兩邊的編碼方式不太一樣、甚至 tokenizer 不太一樣 (但是相容) 應該也是合理的。

[REF]

  1. https://blog.csdn.net/qq_45668004/article/details/138256448

RAG 小註解

Rag 聽起來就像一塊破布. 但是在 AI 領域還滿紅的! 不同於普通的破布, 這個 RAG 是 Retrieval Augmented Generation 的縮寫. 看 keyword 就知道包括檢索 – 增強 – 生成. 整個功能的目標還是做生成式 (generative) AI.

那麼和普通的 LLM 差在哪裡呢? 普通的 LLM 學習了大量的知識, 但是可能有些專業領域沒學到, 或是還可以加強, 這時候就會用 RAG.

首先我們要把這些 “新知" 進行編碼, 在自然語言處理當中會用到 Embedding 技術, 把普通的文字轉換成向量. 此處我們既然想依賴既有的 LLM model, 當然我們要把我們新知和 LLM 的習知, mapping 到同一個空間去! 此時就用到了增強 ( augmented ) 這部分.

Step 1: 找到 Embedding 模型

from sentence_transformers import SentenceTransformer
encoder = SentenceTransformer('一個 EMBEDDING 模型')

Step 2: 為新知建立向量空間

這裡有個熱身的步驟, 先在 memory 當中產生一個 instance.

from qdrant_client import QdrantClient, models
qdrant = QdrantClient(":memory:")

接下來就可以設定新知的參數, 主要是 size 和 distance.

qdrant.recreate_collection(
    collection_name="新知的名稱",
    vectors_config=models.VectorParams(
        size=encoder.get_sentence_embedding_dimension(),
        distance=models.Distance.COSINE
    )
)

Step 3: 把新知的內容搬到向量空間.

其中 data 當然就是由 index (idx) 和 doc 組成.

qdrant.upload_records(
    collection_name="新知的名稱",
    records=[
        models.Record(
            id=idx,
            vector=encoder.encode(doc["新知的內容"]).tolist(),
            payload=doc
        ) for idx, doc in enumerate(data)
    ]
)

Step 4: 以文字在向量空間檢索 (retrieval) 得分最高的新知.

answer = qdrant.search(
    collection_name="新知",
    query_vector=encoder.encode("針對新知的問題").tolist(),
    limit=1 # 想要前幾高分的回答, 例如 1,3,5 
)

for ans in answer:
    print(ans.payload, "score:", ans.score)

由於這個新知的 database 知道的東西比較偏門, 它怎麼跟大語言模型共用呢? 答案就是把上述 RAG 的結果當作 LLM 的提示, 這樣 LLM 就會去 RAG 的輸出找答案.

Step 5: RAG 跟 LLM 互助合作

底下是叫 Copilot 寫的範例. 示意 RAG 的結果被 LLAMA2 拿去參考. 實用性不高, 但畢竟整合起來了.

search_results = [ans.payload for ans in answer] # 上面的新知

# Import necessary libraries
import os
import pinecone
from langchain.llms import Replicate
from langchain.vectorstores import Pinecone
from langchain.text_splitter import CharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.chains import ConversationalRetrievalChain

# Set your API keys
os.environ['REPLICATE_API_TOKEN'] = "YOUR_REPLICATE_API_KEY"
pinecone.init(api_key='YOUR_PINECONE_API_KEY', environment='YOUR_PINECONE_ENVIRONMENT')

# Initialize Llama-2 components
replicate = Replicate()
pinecone_store = Pinecone()
text_splitter = CharacterTextSplitter()
embeddings = HuggingFaceEmbeddings()
retrieval_chain = ConversationalRetrievalChain()

# Example query from the user
user_query = "What are the health benefits of red wine?"

# Retrieve relevant information from search_results (assuming it contains relevant data)
relevant_data = search_results  # Replace with actual relevant data

# Process the user query
query_vector = embeddings.encode(text_splitter.split(user_query))

# Retrieve relevant responses using the retrieval chain
retrieved_responses = retrieval_chain.retrieve(query_vector, pinecone_store)

# Generate an answer based on the retrieved responses
answer = replicate.generate_answer(user_query, retrieved_responses, relevant_data)

print(f"Chatbot's response: {answer}")

用這個方法, 就不需要重 train 大語言模型, 也不影響 LLM 原本的實力. 但看官一定可以發現, 同一個問題必須分別或是依序丟給 RAG 和 LLM, 此時 RAG 才能產出東西給 LLM 當小抄 (in-context prompting). 這就是它的缺點.

使用 Vector Store 並非唯一的方式, 想要學習 WIKI, database, …. 都是可行的. 只要能把它變成 prompt 就可以改善 LLM 資訊不夠新 (knowledge cut off) 的幻覺 (Hallucination) 問題.