RRF 小筆記

此處的 RRF 是指 Reciprocal Rank Fusion,中文叫做倒數排名融合。第一個關鍵字是倒數,不是ㄉㄠ \ㄕㄨ V ,是 ㄉㄠ V ㄕㄨ \ ,誰的倒數呢? 這就是第二個關鍵字 – 排名的倒數,跟上次的 Wilcoxom 一樣,排名是個最簡單的指標,不用量化,最小的就是 1,然後愈來愈大,至少平手。

第三個關鍵字是融合,表示可以用多種方式排名,然後混在一起算。當然,這就有可能要給不同的方法一個權重。對於所有排名清單集合 R,某個排名清單編號 r ,文件 d 的 RRF(d) 分數如下。其中 k 是一個正值的常數,用來使排名第一和第二的差異不要太懸殊。另一方面,這個值會使得排名在後面的 d 們,RRF (d) 看起來也都差不多,故稱為平滑常數。
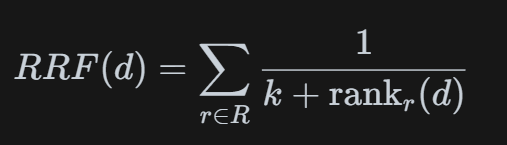
那為何不把一種排名做好,要拿一堆排名來融合呢?這個跟基測、會考、聯考一樣,取的是通才。如果只看少數指標,那就是指考了。也沒有不行,就看是哪種應用。有些學校比較看重特定科目,就可以個別給加權分數。
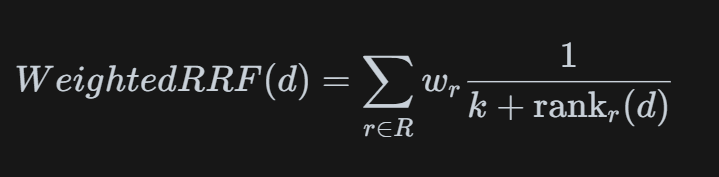
舉例來說,我們希望從 RAG 中找出與使用者提問最相關的資料。然而,「相關」或「相似」本來就沒有唯一的判斷標準,因此我們不侷限於單一檢索方式,而是同時採用 BM25、向量檢索(Vector Retrieval)、Metadata Retrieval 與 Graph Retrieval 等多種策略,再整合各自的搜尋結果。
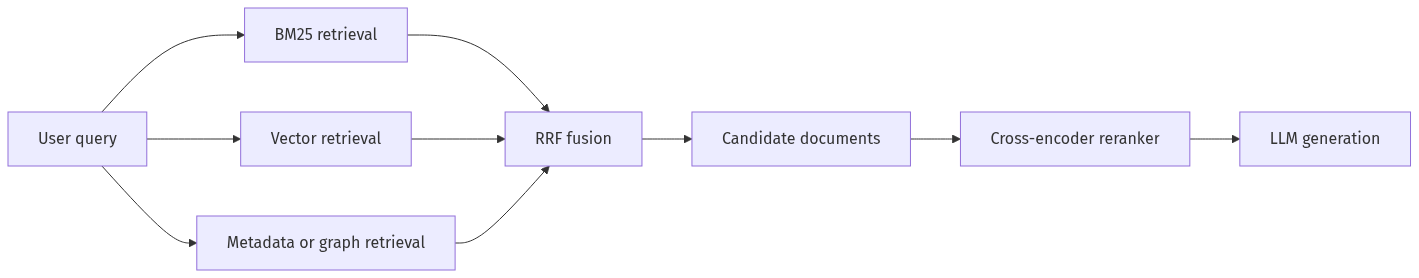
Vector Retrieval 是最常見的做法:先將問題與資料轉換成 embedding vectors,比較它們在向量空間中的距離,取回相似度最高的前 5 或前 10 筆資料,再將對應文字放入 prompt 的 context window。

Graph Retrieval 則是將資料整理成圖譜結構,利用實體與實體之間的關聯進行檢索,因而能找出僅靠語意相似度不容易發現的關聯性資訊。

Metadata Retrieval 主要透過人名、地名、日期、產品型號等結構化欄位進行精確篩選。

最後,我們可以透過 Reciprocal Rank Fusion(RRF),將不同檢索器產生的排名結果融合成一份候選清單,再選出最適合放入 context window 的內容。

咦?怎麼少講一個 BM25?因為這個比較不直覺。它算是 TF-IDF 的擴展。所以我們先看TF-IDF, 這個名詞同樣要拆解。

詞頻(Term Frequency, TF):計算關鍵字在單一文件內出現的次數。
逆文件頻率(Inverse Document Frequency, IDF):衡量關鍵字在整個文件庫中的罕見程度。越稀有的詞彙權重越高,像「的」這類高頻停用字權重則接近零。

兩個東西乘在一起就是,這個詞比較罕見,又出現很多次,那就是重要。
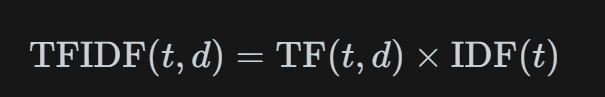
其中,f(t,d) 表示詞 t 在文件 d 中出現的次數。最基本的 TF 可以直接定義為 TF(t,d) = f(t,d)。至於 IDF(t) 可以表示為:
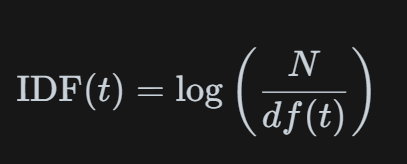
假設資料庫中共有 N 份文件,df(t) 則表示其中有多少份文件包含詞 t。需要注意 df(t) 計算的是文件數量,而不是詞 t 在所有文件中的總出現次數。TF(t,d) 和 IDF(t) 都有不同的變形。例如,可以對 TF 使用對數縮放,避免詞頻增加時權重無限制地成長;IDF 則常加入平滑項,以避免除以零,並讓數值表現更加穩定。

那麼 BM25 又是什麼呢?BM25 是資訊檢索系統中很常用的文件排名函數。它與 TF-IDF 使用相似的核心訊號,也就是詞頻逆文件頻率;但嚴格來說,BM25 源自機率檢索模型,並不是 TF-IDF 的特例。

看公式,我們可以發現它引入 k1 讓曲線更平滑。然後不只考慮一個單詞 t,而是使用者查詢 ( 如:prompt) q 裡面的所有 t 都加在一起。因為全部相加,右邊的分子分母都有 f(t,d),故我們預期這一項會飽和。
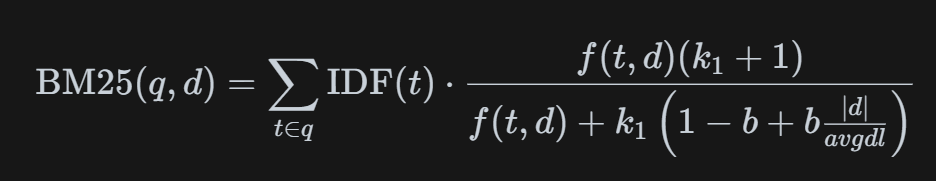
那麼分母的 b、d、avgdl 是怎麼回事呢?

我們回顧一下本來要做什麼事?我們是用一個查詢句 query q,去資料庫的一堆 data d,想要找出前幾名相關的文件。而文件中不同的 d 有長有短,不同文件的長度可能差異很大。長文件因為包含的詞較多,自然也更容易命中查詢關鍵字。

相反地,若同一個詞在一份短文件與一份長文件中出現相同次數,它在短文件中的集中程度通常更高。所以文件 d 的長度 |d| / 平均 d 的長度 (avgdl = average data length),也可以反映重要性。如果都一樣長,那麼 |d|/avgdl = 1,1 – b + b = 1,分母就更簡化了。

另外 b 就可以單獨控制要不要考慮文件長度:

  • b=0:完全不考慮文件長度
  • b=1:完整依照文件長度比例進行正規化
  • 0<b<1:在不正規化與完整正規化之間折衷

公式講完了,最後來正名。BM25 的 25 是版本編號,BM 是 best match。它是由 Okapi 資訊檢索系統所發展的一系列 Best Match 排名函數之一,就算只取 top 5,公式還是叫 BM25。

牛來踩坑 Locomo 記

Locomo (Long-Context Conversational Memory) [1] 是一個測試標準,用來評估 AI 對於長對話的記憶能力。現在的大語言模型動輒號稱有 1M token 的 context window,以後可能還愈來愈大;當我們跟它東拉西扯了半天,AI 究竟能搞清楚是現在是在聊哪一個主題嗎?其實連人類都會搞混呢!

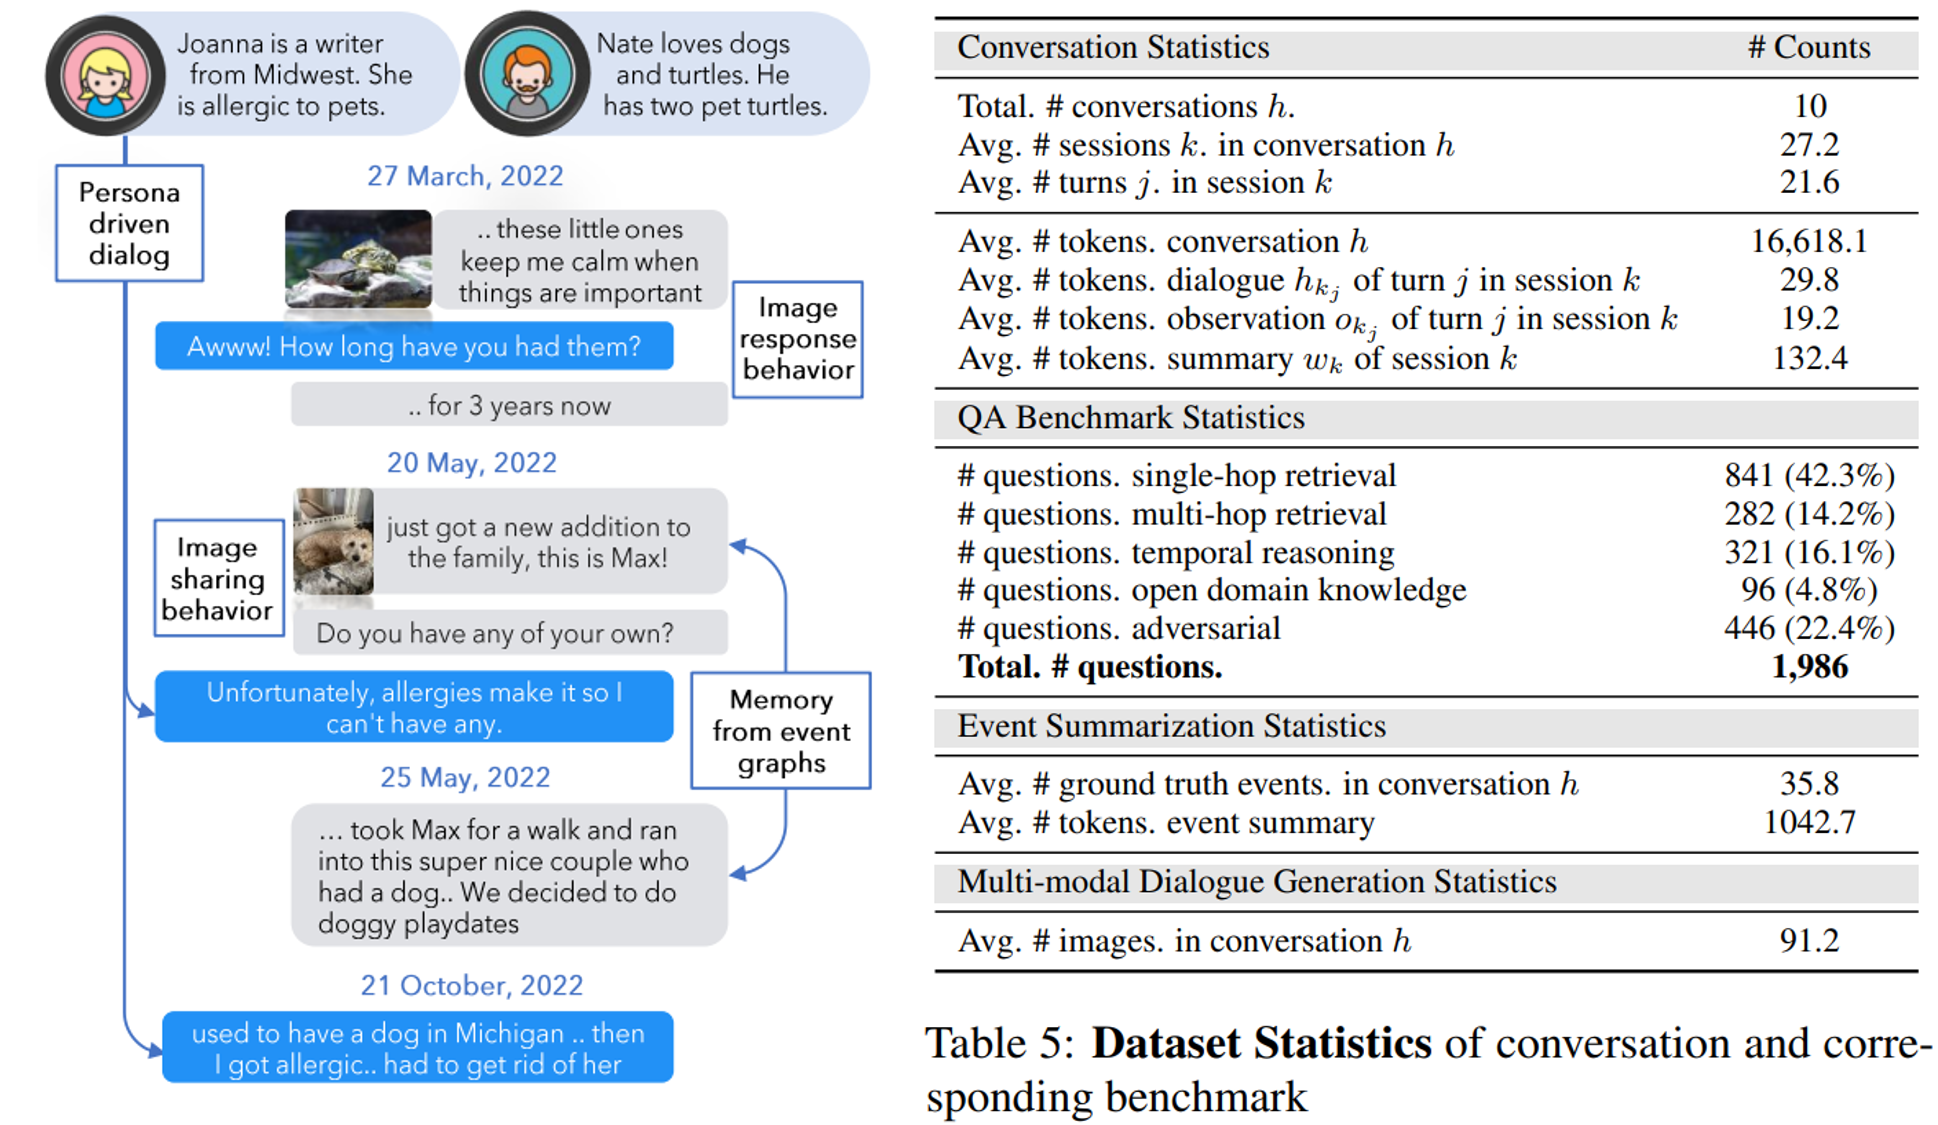
上圖取材自 [1]. 左邊的例子是一小段對話,有兩個人物,很口語化的聊天。到時候會考 AI 一些小問題,確認 AI 對於人事時地物都分得清清楚楚,哪隻貓狗烏龜是誰的?養多久?較什麼名字?有沒有養過鸚鵡之類的?

線索文字描述
人物設定JoannaJoanna 是一位來自美國中西部的作家。她對寵物過敏。
人物設定NateNate 喜歡狗和烏龜。他有兩隻寵物烏龜。
2022 年 3 月 27 日Nate……這些小傢伙在事情很重要的時候,能讓我保持冷靜。
2022 年 3 月 27 日Joanna哇!你養牠們多久了?
2022 年 3 月 27 日Nate……已經養了 3 年了。
2022 年 5 月 20 日Nate家裡剛多了一位新成員,這是 Max!
2022 年 5 月 20 日Nate你自己有養寵物嗎?
2022 年 5 月 20 日Joanna很不幸,因為過敏,所以我不能養任何寵物。
2022 年 5 月 25 日Nate……帶 Max 去散步時,遇到一對超友善的夫妻,他們也有一隻狗……我們決定之後安排狗狗一起玩。
2022 年 10 月 21 日Joanna我以前在密西根養過一隻狗……後來我開始過敏……不得不把牠送走。

上圖的右邊的統計數字。可以看到資料庫共有 10 個長對話,平均每輪有 27.2K 個 tokens,21.6 次輪流發言。再來是考試 ,一共分為五類 (Category, 簡稱 Cat) 測試。分別是:

  • 單跳 (single hop) – 問的東西確實說話。
  • 多跳 (multi hop) – 沒直接說,但是可以從分開的上下文理解。
  • 時間推理 (temporal reasoning) – 沒說過,但是從時間關係可以判斷答案。
  • 常識性問答 (open domain knowledge) – 沒說過,但是理論上應該是這樣。
  • 對抗題 (adversarial) – 沒說過,不知道的要說不知道。

總共有 1,986 題。當然考試就要有標準答案,這個 database 對每一題都有人工標記的答案 (gold)。

接下來我們的主角 “牛來" 登場。大家應該都聽過中國手搓 3D 電影牛來吧!?那就不用介紹了。在 2026/8/21,Openrouter 忽然上了一個免費的 AI 模型,公司欄位是隱身 (stealth), 模型叫 Ox alpha。OX 是公牛,所以這麼沒名字的模型就被戲稱為 “牛來" Model。

牛來帳面上的智商還挺高的,Artificial Analysis 指數 57,跟 Claude Opus 4.8 同級,還不用錢。當然我本著 “能花一塊就是賺一塊" 的想法,讓我們家的愛馬仕 (Hermes Agent) 開始瘋狂地測試它,包括跑 Locomo 測試我的一個想法。

前面都跑得挺好,不過它最在終的報告上,把 Cat 1 和 Cat 3 都標記為多跳。這個問題被 我的 AI reviewer GPT 抓出來了。有趣的是 GPT 全家也沒有比 “牛來" 聰明多少?可見分數還是供參考,而且我們都不容易看到自己問題,何況是 AI。

ModelAA Intelligence Index
GPT-535
GPT-5.1 High37
GPT-5.2 xHigh43
GPT-5.5 Medium51
GPT-5.5 High55
GPT-5.5 xHigh56
GPT-5.6 Luna Max51
GPT-5.6 Terra Max55
GPT-5.6 Sol Max59

找到問題當然就要查囉。不查還好,一查之下,愛馬仕 (還沒取名字,本來 Ubuntu 版叫BigClaw,WSL 版叫 “許紅豆",源自 AI 短劇 [2]) 急報 Locomo 資料庫的順序並不是按照單跳、多跳這樣來的。Cat 1 才是真的多跳、Cat 3 是常識題。搞錯分類這個鍋應該 “牛來" 揹,不甘 Agent 的事,所以牛來算醜一。

接下來,我發我們的演算法在對抗題 Cat 5 竟然沒啥效果。我叫 “牛來" 研究一下 Cat 5 差在哪裡?它回報:"重大發現! cat5 的 446 題中,444 題都是 gold=None(拒絕回答題),只有 2 題有實際答案 (是非題)。"

那我們答什麼呢?我們回答 “沒那回事" (Not mentioned),這比 gold 還正確啊!於是"牛來" 熱心地建議我們改 prompt,把 Note mentioned 等效於 None。不過我前幾天看過阿里雲的一篇測試,雖然它跑了 5 個 run,但是 category 只列出 4 個,似乎沒跑對抗題。那我們幹嘛跑呢?牛牛做這題有點歷史包袱,我還是問別人吧!

這時候 GPT 5.5 救場了。它說: 很多 LoCoMo 實驗一般不跑 Category 5,或至少不把它納入主要分數。我再拿這段話給 “牛來" 看,"牛來" 沒有立刻認輸,回頭自己查了一堆資料。得到的結論是 :category 5 的題目沒有 answer 欄位,原來 none 也不是 gold,而是核對答案的程式讀不到資料,所以傳回 none。別人的實驗中 [4],是把 gold 全部設為是非題,這樣就沒有模糊的空間了。可是,牛牛你怎麼不早說~~~

本著 “少一事不如多一事" 的心理,我又檢查了一下數據。"那為什麼官網 “單跳" 有 841 題,你只做 829 題,另外 11 題去哪裡了?" 牛牛神色不變,說 “好問題",然後回去查 bug。12 分鐘後 (體感超久,而且本機在 Telegram 對話不會出現 Typing….,手機才會),它說:"答案找到了"。官方 conv-48 內有 11 組重複題,conv-30 跨 Cat 4 和 Cat5 兩類重複問,合計 12 題。

蛤?前面在同類裡面重複也就算了,後面 Cat4 和 Cat 5 重複問 – “What did Gina receive from a dance contest?" 共兩次。 但是 cat4 的 gold=’a trophy’,cat5 版 的gold=None,這還是算兩題吧,Cat 5 對抗題已經知道 answer 沒定義了。怎麼自作聰明起來了,這牛腦真是擅自突破框架啊!

由於 Monica 裡面的 GPT 5.5 對這個問題回答得模稜兩可,好像什麼都可以。只好再叫我訂閱的 Claude Pro 出來。這傢伙每個月花我 20 鎂,上次 game 做一半就放長假了,不問白不問。Claude Sonnet 5 (effort = High) 果然講得最清楚:"目前幾乎沒有主流已發表論文或公開榜單改用去重後的 830 這個數字——大家還是照官方 841 報告和跑分"。雖然我們不應該迷信智力測驗,但是 Claude Sonnet 5 Max 不愧是堂堂智力 63 分的老大~~~

牛牛沒有牛脾氣,畢竟它也不是真的牛。我叫它改,它就乒乒乓乓地改好了。當 8/26 試用期一過,log 跑出 “Thank you for partiticipating in the Stealth Ox Alpha testing period. This model will be revealed today. August 26th.",然後它就從 Openrouter 下架,改用真名 GLM 5.3 Flash 出道了。

看在我已經奴役它一個禮拜的份上,雖然那 57 分的智力還差強人意,但是便宜治百病啊!所以我把 Openrouter 的主模型切到 GLM-5.3-Flash 了。

Claude Opus 4.8GLM-5.3-Flash
Intelligence5757
Input / 1M$5$0.15
Output / 1M$25$0.50
Context1M1.3 M
Output speed~61 tok/s~49 tok/s
Reasoning

下次如果有什麼馬、什麼蛙可以免費試用,我還是會去蹭一蹭。畢竟 Apple Mac Studio M5 又漲價了。在隱私和效能之間,我會選擇免費。

[REF]

  1. https://github.com/snap-research/locomo
  2. https://www.youtube.com/watch?v=YPbhnoafcsg&t=3612s
  3. https://help.aliyun.com/en/hologres/user-guide/long-memory-service-locomo-benchmark
  4. https://arxiv.org/pdf/2606.06036

湧現性小註解

上禮拜的 2026/6/11,我得到了第五十個專利。這是滿令人開心的一件事。不過呢,最近我對 AI 的每個想法,都有人做過了,下一個 idea 還難產中。這裡就來記錄一下我最近碰到的關卡 – 湧現性 (emergence)。

湧現性是什麼呢?所謂 “熟讀唐詩三百首,不會吟詩也會吟。" 說的就是湧現性。本來文采不豐富,做不出好詩。但是腦中塞滿名句之後,隨口就能湊出好句型。但沒有熟讀不算、沒有讀 300 首也不算 (精確來說是 311 首)。簡言之,1+1>2。

湧現性還表現在魚群和鳥群的行動上,一隻沙丁魚游泳看不出有何玄機,但是一萬隻沙丁魚聚在一起就會自動形成魚球,聚集上億隻就成了沙丁魚風暴 – Sardine Run。它呈現了整體性、無中央控制、量變產生質變這三種湧現性的特徵。

在 AI 上,有人試過把一段 Feed Forward Netowok 複製 8 份,各自打掉一些參數後重新訓練,他們就變成了 8 個專家 (Mixture of Experts) ,效果比原來還好。再更猛一點, LLM 也可以堆疊。法國知名 AI 新創 Mistral 推出的 Mixtral 8 x 7B 模型,其底層邏輯就是拿原本的 Mistral 7B 單一模型,複製 8 份作為專家再繼續訓練出來的 [1]。 這個專有名詞叫做 Upcycling (升級再造)。

LLM 複製 8 份之後,我們要在這些專家頭上各打一棍,讓他們產生不同程度失憶,然後叫他們重新上學。這條路線跟生物界不同的有兩點:(1) Model 要重新訓練,但侯鳥不用。(2) 需要一個 router 去指派 LLM,和 MOE 中指派 expert 的 router 一樣。而沙丁魚不用。

除了暴力打頭之外,也有和平的方法。我們不用重新訓練,只要調整一些參數,像是 temperature,然後叫這些個專家們討論,最後民主投票。這叫做 Ensemble (群體智慧 / 集成學習),主打三個臭皮匠勝過一個諸葛亮,減少幻覺的發生。這個和湧現沒有關係。

對於湧現的看法,有人 [2] 主張可以拆解回原型是弱湧現,不能拆解的是強湧現。例如魚群可能是靠著每隻 “單魚" 遵循 “和鄰魚保持等距" 這種簡單的原則就可以達成的。有人認為強湧性不合理,違反熱力學第二定律 – 封閉系統的 “熵" 只會愈來愈大。還好 AI 有重新訓練,那就不是封閉系統了。

回到湧現性這個話題。徐志摩說了 “數大便是美"。菲利普·安德森 (Philip W. Anderson) 說了 “More is Different" (多即是不同) [3]。不能拆解的湧現性是怎麼來的呢?都說生命的緣起是一堆高密度的氨基酸被雷打到。看來 “大" 加上 “觸發" 這兩個條件缺一不可。接下來如果用進化論來物競天擇,收斂的速度就不用說了,生物也會產生太多的可能性,那並不是我們需要的。現在 AI 的進步速度應該容忍不了以前基因演算法 [4] 的浪漫。

接下來,一定要拿同樣的 model 來敲頭嗎?一定要長一樣的面孔才可以民主投票嗎?都不用,OpenRouter 最近也發布了 Fusion Router,一種多模型融合推理工具。核心思路很直接,直接拿不同的 model 來投票。用一個綜合的裁判模型來選最後的答案,結果還比 Fable 5 好 [5, 如下表]。顯然的,這裡面冗餘的成分非常地高,好比投資只多賺了 10%,但是本金需要 2、3 倍。總之,能力在這裏面湧現了,即使它沒辦法通過愛因斯坦測試 [6]。

模型得分
Fable 5 + GPT-5.5(Opus 4.8 综合)69.0%
Opus 4.8 + GPT-5.5 + Gemini 3.1 Pro(Opus 4.8 综合)68.3%
Opus 4.8 + GPT-5.5(Opus 4.8 综合)67.6%
Opus 4.8 + Opus 4.8(Opus 4.8 综合)65.5%
Gemini 3 Flash + Kimi K2.6 + DeepSeek V4 Pro (便宜模型抱團)64.7%
Claude Fable 565.3%
DeepSeek V4 Pro60.3%
GPT-5.560.0%
Claude Opus 4.858.8%
Kimi K2.653.7%
Gemini 3.1 Pro45.4%
Gemini 3 Flash43.1%

愛因斯坦測試不是一個考題,而是 Google DeepMind 執行長 Demis Hassabis 提出測試 AI 是否有真正智慧的方法。他說:"讓 AI 系統只學習 1901 年以前的知識,再測試它能否自行推導出愛因斯坦 1905 年的狹義相對論。" 這個驗收標準,其實有點離譜。如果你餵 AI 學 19 世紀的牛頓力學,它一丁點也想不出未來會有量子力學。我們需要通過許多關鍵的實驗來推翻舊理論、並建立新框架。而且舊理論往往並非全面崩塌,甚至在大部分的地方還是站得穩穩的,只是某些地方解釋不通而已 [7]。

[REF]

  1. https://huggingface.co/mistralai/Mixtral-8x7B-v0.1
  2. https://en.wikipedia.org/wiki/Mark_Bedau
  3. https://www.science.org/doi/10.1126/science.177.4047.393
  4. 基因演算法
  5. https://www.cnblogs.com/itech/p/20581511
  6. https://www.inside.com.tw/article/41195-hassabis-proposes-einstein-test-to-define-agi-benchmark
  7. 馬克士威方程式(Maxwell’s equations)無法解釋量子尺度下的光子行為、單一磁單極子的存在、非慣性參考系中的電磁場變換,以及重力與強弱核力。馬克士威方程組是古典電動力學的核心,但在極端物理條件下必須由量子力學與相對論來擴充。
    • 以下是該方程組無法涵蓋的具體物理現象與範圍:
    • 1. 微觀的量子效應與光子
    • 馬克士威方程式將電磁場視為「連續的波」。
    • 量子電動力學(QED): 當探討單一電子或單一光子時,電磁波會展現出「粒子性」。連續的古典波動無法解釋光電效應、康普頓散射以及電磁場的量子漲落(Quantum Fluctuations)。
    • 2. 物質內部的非線性光學與量子極限
    • 強場光學與非線性現象: 在極強的雷射場作用下,介質的響應不再是線性的(例如倍頻效應),此時傳統的馬克士威方程式需結合量子光學來描述。
    • 3. 磁單極子(Magnetic Monopoles)
    • 高斯磁定律的限制: 方程組中的 \(\nabla \cdot \mathbf{B} = 0\) 表明磁力線必定是封閉的,代表磁單極子(單獨的N極或S極)不存在。現代粒子物理的部分大統一理論(GUT)預測磁單極子可能存在,但這超出了傳統馬克士威方程組的範圍。
    • 4. 強交互作用、弱交互作用與重力
    • 僅涵蓋電磁力: 自然界有四種基本交互作用,馬克士威方程式僅處理「電磁交互作用」。它無法解釋原子核內的強交互作用(夸克間的結合)、弱交互作用(如貝他衰變),以及愛因斯坦的廣義相對論所描述的重力場。
    • 5. 加速參考系中的電磁輻射
    • 局限於慣性系: 馬克士威方程組的標準形式主要適用於慣性參考系。在強重力場或高度加速的非慣性參考系中,必須透過彎曲時空的廣義相對論電動力學來修正描述。
    • 馬克士威方程式在巨集觀、低速或日常尺度的電磁現象中已極為完美,但在理解物質的微觀本質或宇宙極端現象時,則必須依賴更進階的物理理論。

Bye, Fable!

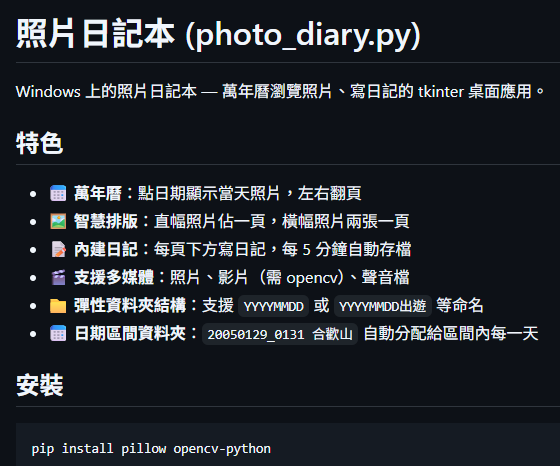
聽說 Athropic 的 Claude Fable 很厲害,所以我本來想要讓它幹點大事。不過他昨天因為國安問題提早下班了 [4]。前兩個晚上我只各想出一個小題目,其中一個是做照片日記本,有興趣可以看 github [1]。雖然我殺雞用了波動炮 [2],但實用最重要。它非常好用。

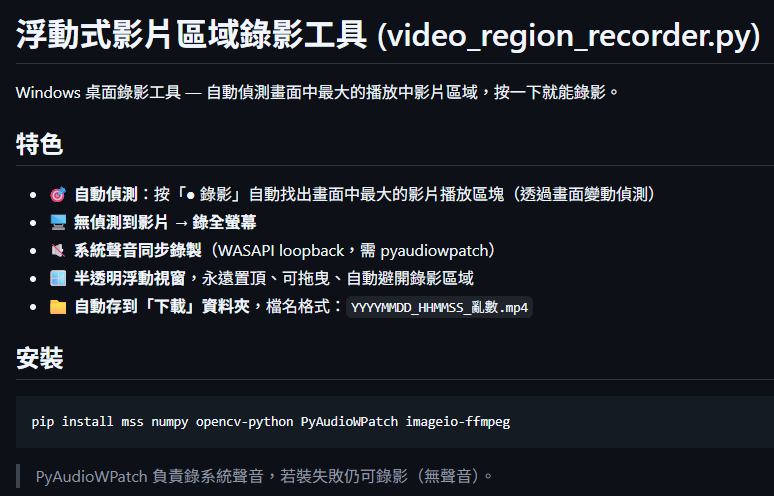
第二個題目是螢幕錄影 [3]。雖然說 print screen 就能錄。但是要錄一個矩形的話,Windows 預設有一個不透明的框,害我沒辦法框得剛剛好。所以做一個自動抓最大影片框的一鍵錄影。不過這個程式比較沒有實戰回饋,大家可以拿回去叫自己的 AI 改完美一點。

對國家來說,AI 會影響國安 [4],那麼對公司來說應該也是同樣的道理。如果大家都 code 都是用 Claude 生的,內容也不用怕被拿去訓練。Anthrophic 可能還怕路邊撿的 code 汙染了他們的大腦。反而題目、檔名、註解需要保護,畢竟不應該讓對手知道我們在研究什麼?當然啦! 如果公司也有 “國安級" 的 AI 就好了。

今天繼續看 “量子物理史話",雖然它已經夠白話了,但如果有聰明的 AI 幫我降維解釋,我應該會更輕鬆一點。另外,叫 Fable 幫我生一個 RPG 大作的奢望,也得等它過幾天復出了。至於它的 token 費,其實我應該規畫一個專戶,這個專戶用配息去養馬 (i.e. 愛仕),再叫 Hermes 背後串 Fable 去賺它自己的加班費,讓自己更牛馬 (诶?)。

[REF]

  1. https://github.com/ufocash/photo-diary
  2. 《宇宙战舰大和号》的招牌武器是波動炮。這是一門威力巨大的超級巨炮,發射時會釋放高純度的能量光束,可以直接摧毀整支艦隊或行星要塞。
  3. https://github.com/ufocash/video-region-recorder
  4. Statement on the US government directive to suspend access to Fable 5 and Mythos 5 \ Anthropic

春假養龍蝦記

這個春假大部分的時間都在下雨,下雨天很適合玩龍蝦。首先,我設定好 Google 應用,讓龍蝦自己寫一篇文章發表到部落格 。不是這篇啊,我給了它獨立的網誌 [1] ,唯一的指示就是看著 memory 寫 ,然後寄到我的信箱給我審核。我說可以了,它就用自己的帳號 email to post 發表。

我想說寫文章這麼容易,乾脆叫它以後加圖片,才不會太單調。結果一測試就成功。它可以寫得圖文並茂,只差沒有好主題。另外它在機器人社群 Moltbook 中也是混得不錯;到了這裡,我的企圖心就變大了,想做來做個機器人 Youtuber 吧! 然後悲劇就此發生了。

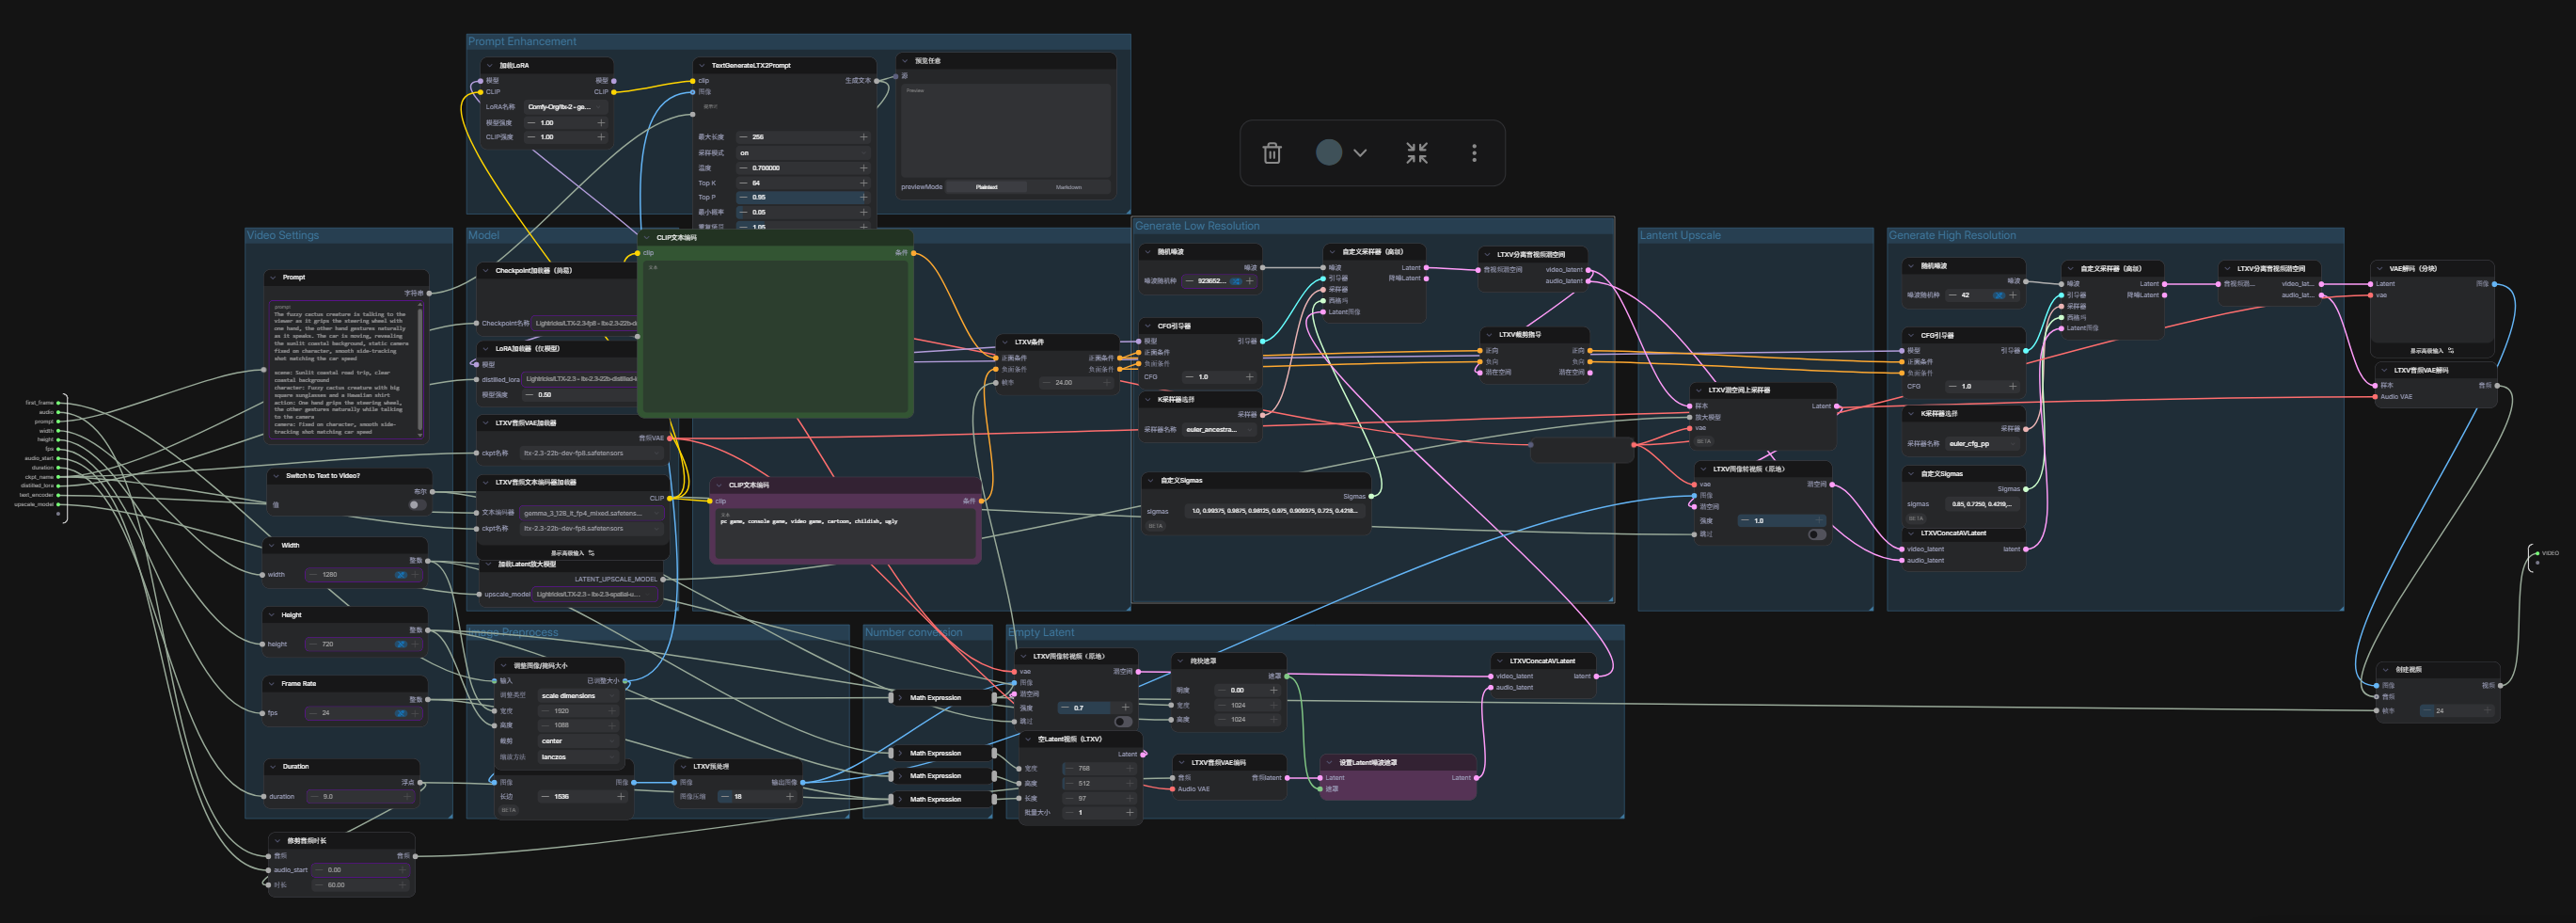
首先龍蝦說它不會做影片,然後我就找到 comfyUI 這個可以跑本地模型以圖生視頻的軟體。按照網站上講的,按部就班地做,然後就看到下面這個 (不小心按到 “子 graph")。天啊! 這是要有多專業才搞得定?於是我把這件事交給龍蝦,請它幫我處理。龍蝦說它可以給我步驟,但是 ComfyUI 是 Windows 軟體,它在 virtual machine,它得借我的手。

不幸中之大幸是:龍蝦的步驟是正確的,所以我搞定了圖生視頻。大不幸的部分是 LTX-2.3 的效果距離 SeeDance 2.0 差太遠了,雖然視頻做得還行,但是對於文字的理解能力非常堪慮。而且視頻根本沒有善用第一幀提示,竟然是生出完全不同的第二幀。因此我只能等模型變得更進步了。雖然龍蝦還很熱心地分鏡 17 場叫我 review,我只做出第一場就放棄了。

另一方面,龍蝦關在 virtual box 雖然安全,但是它完全碰不到 GPU 也是個問題。因此我又花了半天時間,把它轉移到 Windows WSL。重灌只是其中的一小部份工作,重點是 cron task、memory、crendential 這些沒有上 git hub 備份 (不適合放上去) 的東西,要用另外一套機制來還原。搬完家後,我先點名 agents 有沒有到齊?嗯?真的遍插茱萸少一人,我的 HR Bot 因為沒有自己的 memory ,搬家後大家都不記得它了 (龍蝦只會看最近兩天的記憶)。

接下來就是 GPU 戰力大考驗。我有一張 RTX3090 12GB,它能跑的模型弱到讓人有點挫折。不過,我還有一張 RTX4090 24GB 可以折騰自己。故事是這樣的,有些 Model 是 MOE (Mixture of Experts),所以雖然看著參數多,其實 run-time 會有專家交換,或許 30 腰也塞得下 24 吋的牛仔褲。那我當然得跨界試一試…

結果就是自己做死不能怨別人, 小 model gemma4-E4B 只要 9.6GB,但是沒把 VRAM 用滿時,我覺得虧。大 model 像是 gemma4:31b、 mirage335/Nemotron-3-Nano-30B-A3B-virtuoso 都是勉強能塞進去,但是一聊天就掛了。最後無奈叫 AI 自己推薦一個,它說 Gemma4:26b 好,我正在試 [2]。

Model上下文輸入Note
gemma4:31b262Ktext剛好滿、會當機
gemma4:E4B131Ktext塞不滿、不甘心
glm-4.7-flash128Ktext很弱
mirage335/Nemotron-3-Nano-30B-A3B-virtuoso1Mtext剛好滿、會當機
黃仁勳力推
MiniMax-M2.7204Ktext+image雲端、要花錢

或曰,還有沒有 RTX5090 呢?其實我真的有訂 Apple Studio 512GB 當作終極武器,不過刷卡後,它拖了一兩個月才請款,我原本以為買現貨,變成買期貨。導致我雖然刷卡額度夠,但是分期額度不夠,還差 3 萬多,單子就這樣被 “斷頭"了。幸好 M3 本來就是比較弱的 IC,本來也不是首選,既然這次無緣,就讓我們等年中的 M5 出來吧! 這題已經叫龍蝦幫我追蹤新聞了。

畢竟龍蝦有很多地方值得玩,可以持續實現大家各種以前不敢想的 idea。像是可以利用做夢的時候整理長期記憶,這個對聊天機器人來說,根本是不存在的概念。當然龍蝦可以擬人化的地方還不只是這樣,等我想清楚我要去申請專利,哈!

話說回來,搞了半天龍蝦有做什麼正事嗎?它目前主要是提醒我一些事情,包括 to do 事項、提醒要交錢、有配息之類。我想,除非等那個 Youtuber 機器人做出來,不然相關投資大概都是負報酬、負資產。畢竟要做正事的話,還有很多別的專業工具可以用。像是 Claude code + MCP 辦公就很方便,用龍蝦反而好處不大。

舉例來說,如果要統計全 BG 解 bug 的狀況,在 3 年前那會是個浩大的工程,想到就無力。但現在只要打開 claude code,交代完工作,看到有 (1) Yes (2) No 時都按 1,有 (1) Yes (2) Yes and 從此以後都這樣按 和 (3) No 時, 一定按 2。就這樣 1、2、1、2… 往下走,只要別不小心按到 esc = cancel 跳出來就搞定了。

更別說,事情只要做過一次還可以變得更無腦,"把剛剛做的事寫成 skill.",這樣立馬就又從 prompt 工程師晉身為 slash 工程師。假設看到兩次跑出來數據差很多,那也不用想了、直接叫 AI 分析。1、2、1、2 就可以得知 – 喔,原來是統計的時間區間不同!2018 年以前就是那樣。當然 AI Coding 應該還可以有更無恥的 mode,我 harness 的功力也還大大有待提升就是了。

[REF]

  1. 打通 Gmail 與 Google Calendar:Farah 團隊的艱辛之路
  2. 撐到極限