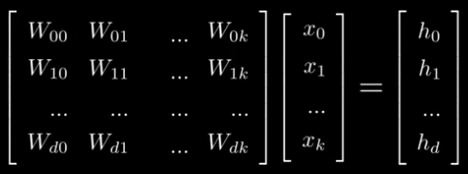道友,報上名來

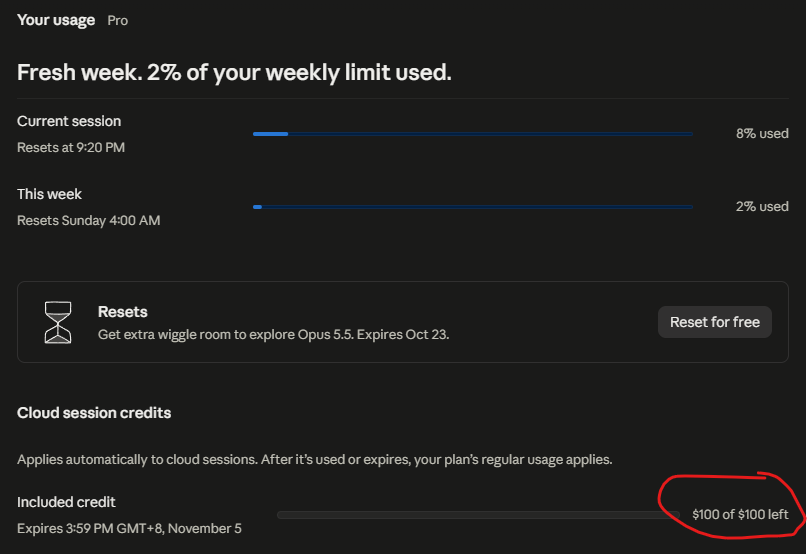
Antropic Claude 這幾天有一個福利,就是 Pro、Max 的用戶,可以申請 100 或 250 USD 的 credit。除了從終端機 CLI 打 “/claim-credit" 申請、也可以直接用 http://claude.ai/code [1]。我是用網路版申請。瀏覽器內點左下角頭像、然後選 Setting、Usage 這種方式。總之按下 “claim-credit" 就有 100 USD,不拿白不拿,10/7 前領取。

這個福利有使用期限,只到 11 /5。下午我靈機一動,就用 Fable 做了這個 APP。主要是參考 Liferest [2],把自我提升當作 RPG 遊戲。介面當然是繁體中文,等級當然也是中式的修仙等級,搭配神話 (Fable) 剛好而已。
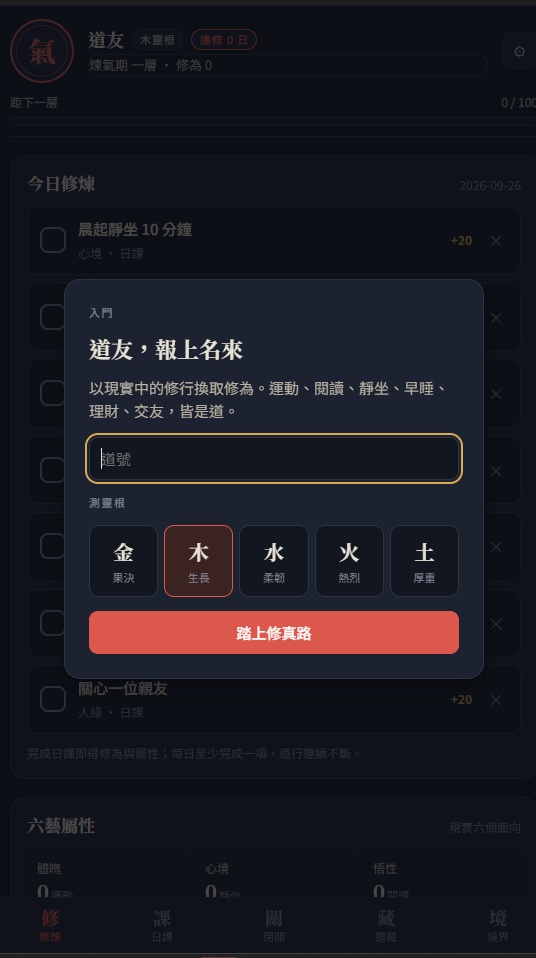
鍛鍊的內容像是這樣。認真改良的話,還可以修五靈根、體修、…。
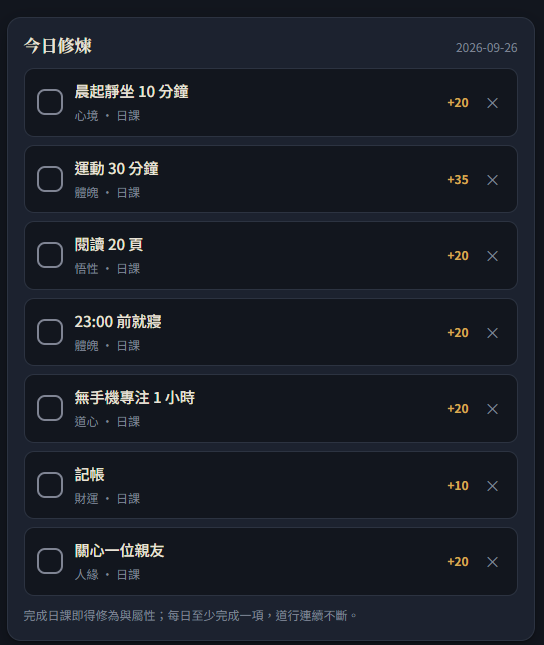
總之 Claude 聽懂我簡短的需求,沒幾分鐘就做好了這個,還有 README。.笑死人了!

九大境界共 46 層:煉氣一~九層;築基到大乘各分初期/中期/後期/圓滿;渡劫分一~九重雷劫。每層所需修為 = 100 × 1.16^層數,滿了按「突破」,跨境界時觸發天劫畫面,渡完九重雷劫則飛升。

六藝屬性對應現實六面向:體魄、心境、悟性、道心、人緣、財運。

五個分頁:修煉(今日日課、屬性、突破、紀錄、連修天數)、日課(每日重置的日課+一次性機緣任務,可自訂難度)、閉關(15/25/45/60 分專注計時,每分鐘 1 修為)、道藏(每日心得+心境標記)、境界(46 層總覽)。設定裡可改道號、複製/匯入 JSON 備份、重修。

我第一步我請它做網頁版,第二步才是打包 Android APP。而且從這邊開始,我把 Fable 降級到 Sonnect。

我來做 Android 版:用原生 WebView 殼(Kotlin + Gradle)包住現有的 App,並加上 GitHub Actions 自動編 APK;同時把網頁版加上 PWA 設定,手機瀏覽器可直接「加到主畫面」。先看這裡有沒有能編 APK 的環境。

Android 版做好了,兩種形式都有:

1. 原生 Android APP(android/)

  • Kotlin WebView 殼,載入同一份 index.html(編譯時自動從專案根目錄複製進 assets,網頁版改了 App 就跟著改)。
  • 套件名 com.lifereset.xiuzhen、Android 7.0+;用 WebViewAssetLoader 給 localStorage 固定 origin,修為資料不會遺失;跟隨系統深色模式;返回鍵、外部連結、鍵盤 inset 都處理了。
  • App icon 是朱砂「氣」字印(adaptive icon + 各 dpi 的傳統 icon)。

2. PWA

  • 加了 web/manifest.webmanifest、sw.js 離線快取與 icon;放上 GitHub Pages 後,手機 Chrome「加到主畫面」就是獨立視窗的 App,不裝 APK 也能用。

Claude CLI 反而不像 Antigravity 那樣會自動幫忙下載 Android Studio。所以這邊是用 GitHub Actions workflow [3],Claude 再幫忙加個 .github/workflows/android.yml。然後我把 code push 上 Github,Github Actions 分頁的「Build Android APK」跑完就能下載 APK [4]。可能有 bug,但是 Android 安裝程式掃過無毒。很好奇的話可以安裝在 Android 開發板上。

結果,這題難度太低了。根本沒燒到那 100 USD。這兩天再想想。
[REF]
  1. https://www.threads.com/share/Fwl8NnuVj/
  2. https://www.lifereset.com/
  3. https://github.com/apps/claude/installations/select_target
  4. https://github.com/ufocash16785/liferest/actions/runs/36242519954/artifacts/10906776662

龍蝦寫信小筆記

我請龍蝦幫我摘要 arxiv 的論文,然後寄給我。但龍蝦說它不會寫信,還想出一堆替代方案 – 這簡直就是不負責任。剛才好不容易教會它,因此我也要趕在記憶揮發前,做個筆記把過程寫下來。

幫龍蝦增加收發 mail 的能力。看攻略應該是在 config 設定就可以了,但我在 Ubuntu 上顯然沒那麼簡單。

[階段 0 – 申請帳號]

首先登出自己的 google account,幫龍蝦申請一個 “個蝦" 帳號。像是 Claw123XYZ@gmail.com.

[階段 1 – 編 gog]

    安裝 Go 語言環境 (如果尚未安裝) ,gogcli 需要用 Go 來編譯。在 Ubuntu 上執行:

    udo apt update
    sudo apt install golang

    下載並編譯 gogcli 依照您提供的指令,將原始碼抓下來並編譯

    git clone https://github.com/steipete/gogcli.git
    cd gogcli
    make

    然而,此時應該編不過。我裝好龍蝦 2026.3.13 版本時,系統預設 tidy 是 1.23。所以我試著更新 go 到最新的 1.25.8 和 1.26.1,結果都沒用。問了 AI 可以退版,所以我到 gogcli 下面,找到 go.mod. 用 editor (e.g. vi) 手動 hack.

    // go 1.25.8
    go 1.18

    重新 make 後, 雖然多跑了一點,還是 build error。 我變成在 1.18、1.23、1.25.8、1.26.1 四個版本中掙扎了。總之,我的解法是來回改,最後確認版本和位置,統一到最新版。

    go version // 最後是 1.26.1
    which go // 把正確的 go 加到 PATH

    此時還會看到最後一次error,但是可以用 mod 搞定。

    go mod tidy
    make

    產生 gog 之後,才能對 gmail 做 auth。這完全是另外一件工作。

    [階段 2 – 申請憑證]

    • 前往 Google Cloud Console。
    • 登入龍蝦本蝦的 google 帳號。
    • 點擊左上角建立一個新專案 (New Project),名稱可自訂。
    • 在左側選單進入 「API 和服務」 > 「程式庫」,搜尋 Gmail API 並點擊「啟用 (Enable)」。
    • 進入 「API 和服務」 > 「OAuth 同意畫面」,選擇「外部」,隨便填寫必填的應用程式名稱與龍蝦的電子郵件,然後儲存。(其實「內部」根本不能選。)
    • 進入 「API 和服務」 > 「憑證」:
      • 點擊上方「建立憑證」 > 「OAuth 用戶端 ID」。
      • 應用程式類型選擇 「網頁應用程式 」。
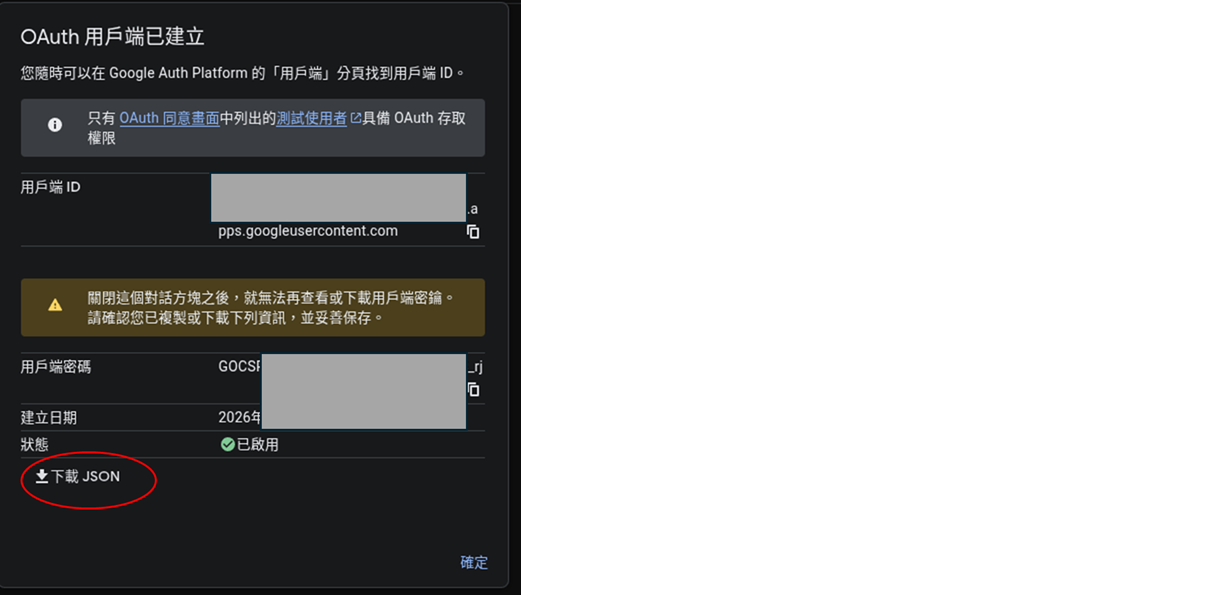
      • 點擊建立後,從下方的紅色圈起來的地方下載 JSON 檔案。
    • 將這個名字很長的 JSON 檔案重新命名為 client_secret.json,並移到好保管的目錄下。接著認證這個憑證
    gog auth credentials ~/Downloads/client_secret.json
    • 對 email 加上這個憑證。
    gog auth add Claw123XYZ@gmail.com
    • 因為我把 APP 登記為網頁應用程式,所以 auth 的時候,忽然自動開了一個網頁。原來是我忘記先 enable Gmail API,但這時做都還來得及。後續再把這個email 設為預設帳號。
    export GOG_ACCOUNT=Claw123XYZ@gmail.com
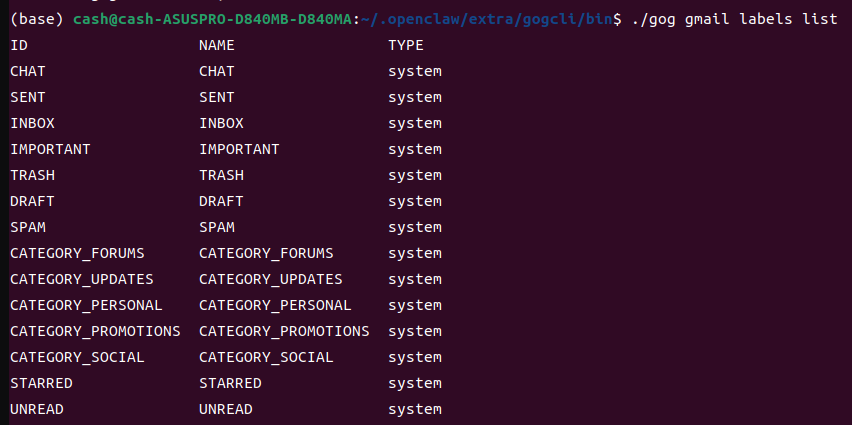
    • 測試信箱是否建立? 看到收件夾這些都在,表示沒問題。
    gog gmail labels list
    • 發個信給別人
    gog gmail send --to="Claw456@gmail.com" --subject="蝦一跳" --body="我是龍蝦。"

    收到信了,表示 account 大功告成。

    超學習時代

    最近的 Gemini 3 Pro 真的變比較聰明,所以我取消 Monica 的訂閱,改訂 Gemini。現在想要學習最新的技術,不但學校教不了;網路課程也教不了。就算是追著科技網紅,心裡沒有譜的話,也會像個無頭蒼蠅一樣、不會授粉只會傳播細菌,哈!

    以 AI 技術來說,訓練模型、微調模型、RAG (檢索增強生成) 都是舊世代的技術。次世代的技術重點在於 Reasoning 和 Agency。雖然這個發展有跡可循、合情合理,但是沒有前面的跌跌撞撞,也絕不可能一步到位。短短一兩年之間,我們有了下面的這些進化。

    [觀念改變]

    一個 AI model 自己角色扮演 –> 建立認知架構:記憶、規畫、反思。

    LangChain –> LangGraph, 線性思考 –> 非線性思考、圖論、立體化。

    Funcation call –> Tool call。錯誤檢查和自我校正。

    [模型調校]

    Supervised Fine-Tuning、 RLHF (reinforcement learning from human feedback) –> DPO (Direct Preference Optimization)、IPO (Identity Preference Optimization)、KTO (Kahneman-Tversky Optimization)。

    全能模型 –> SLERP (Spherical Linear Interpolation)、TIES-Merging。

    自我對局 (Self-Play) 強化。

    [In Model Learning]

    Prompt –> DSPy (Declarative Self-improving Language Programs),透過 Compiler 自動尋找 Prompt 組合。

    快問快答 –> Chain of Tought、Tree of Thought –> Test-Time Compute (有節制地想久一點,時間換取品質)

    [模型評估]

    BLEU、ROUGE 考試 –> LLM-as-a-Judge,自動評估

    多元評價 – RAGAS

    • R:Retrieval(檢索)
    • A:Accuracy(準確性)
    • G:Generality(通用性)
    • A:Adherence(遵循性)
    • S:Stability(穩定性)

    [多模態]

    OCR + LLM –> 原生多模態 (Native Multimodel)、audio/video tokenization。

    文字到文字 –> any-to-any interaction

    上述有很多新的東西,也有一些半新半舊,我打算加強 Agentic、MCP 這方面的知識,然後快速進入 DSPy 的領域。

    附帶一提,雖然退訂 Monica 可以省錢,但是我還不打算把 Coursera 停掉。因為上面還是有很多 Andrew Ng 開的短課程。愈長的課程愈容易過時、短課程甚至像  Andrej Karpathy 的 Youtube 都可能有一些最新的東西。至於 ArXiv 肯定好料滿滿,但是可能要叫 NoteLLM 幫我讀了。

    RAG with FAISS

    RAG (Retrieval-Augmented Generation) 大家應該都知道了。至於 FAISS 是 Facebook AI Research(FAIR)開發的技術,主要用途是對海量高維度的資料作出相似度的比較。由於我是第一次看到 RAG 和 FAISS (Facebook AI Similarity Search) 一起用,所以做個筆記。

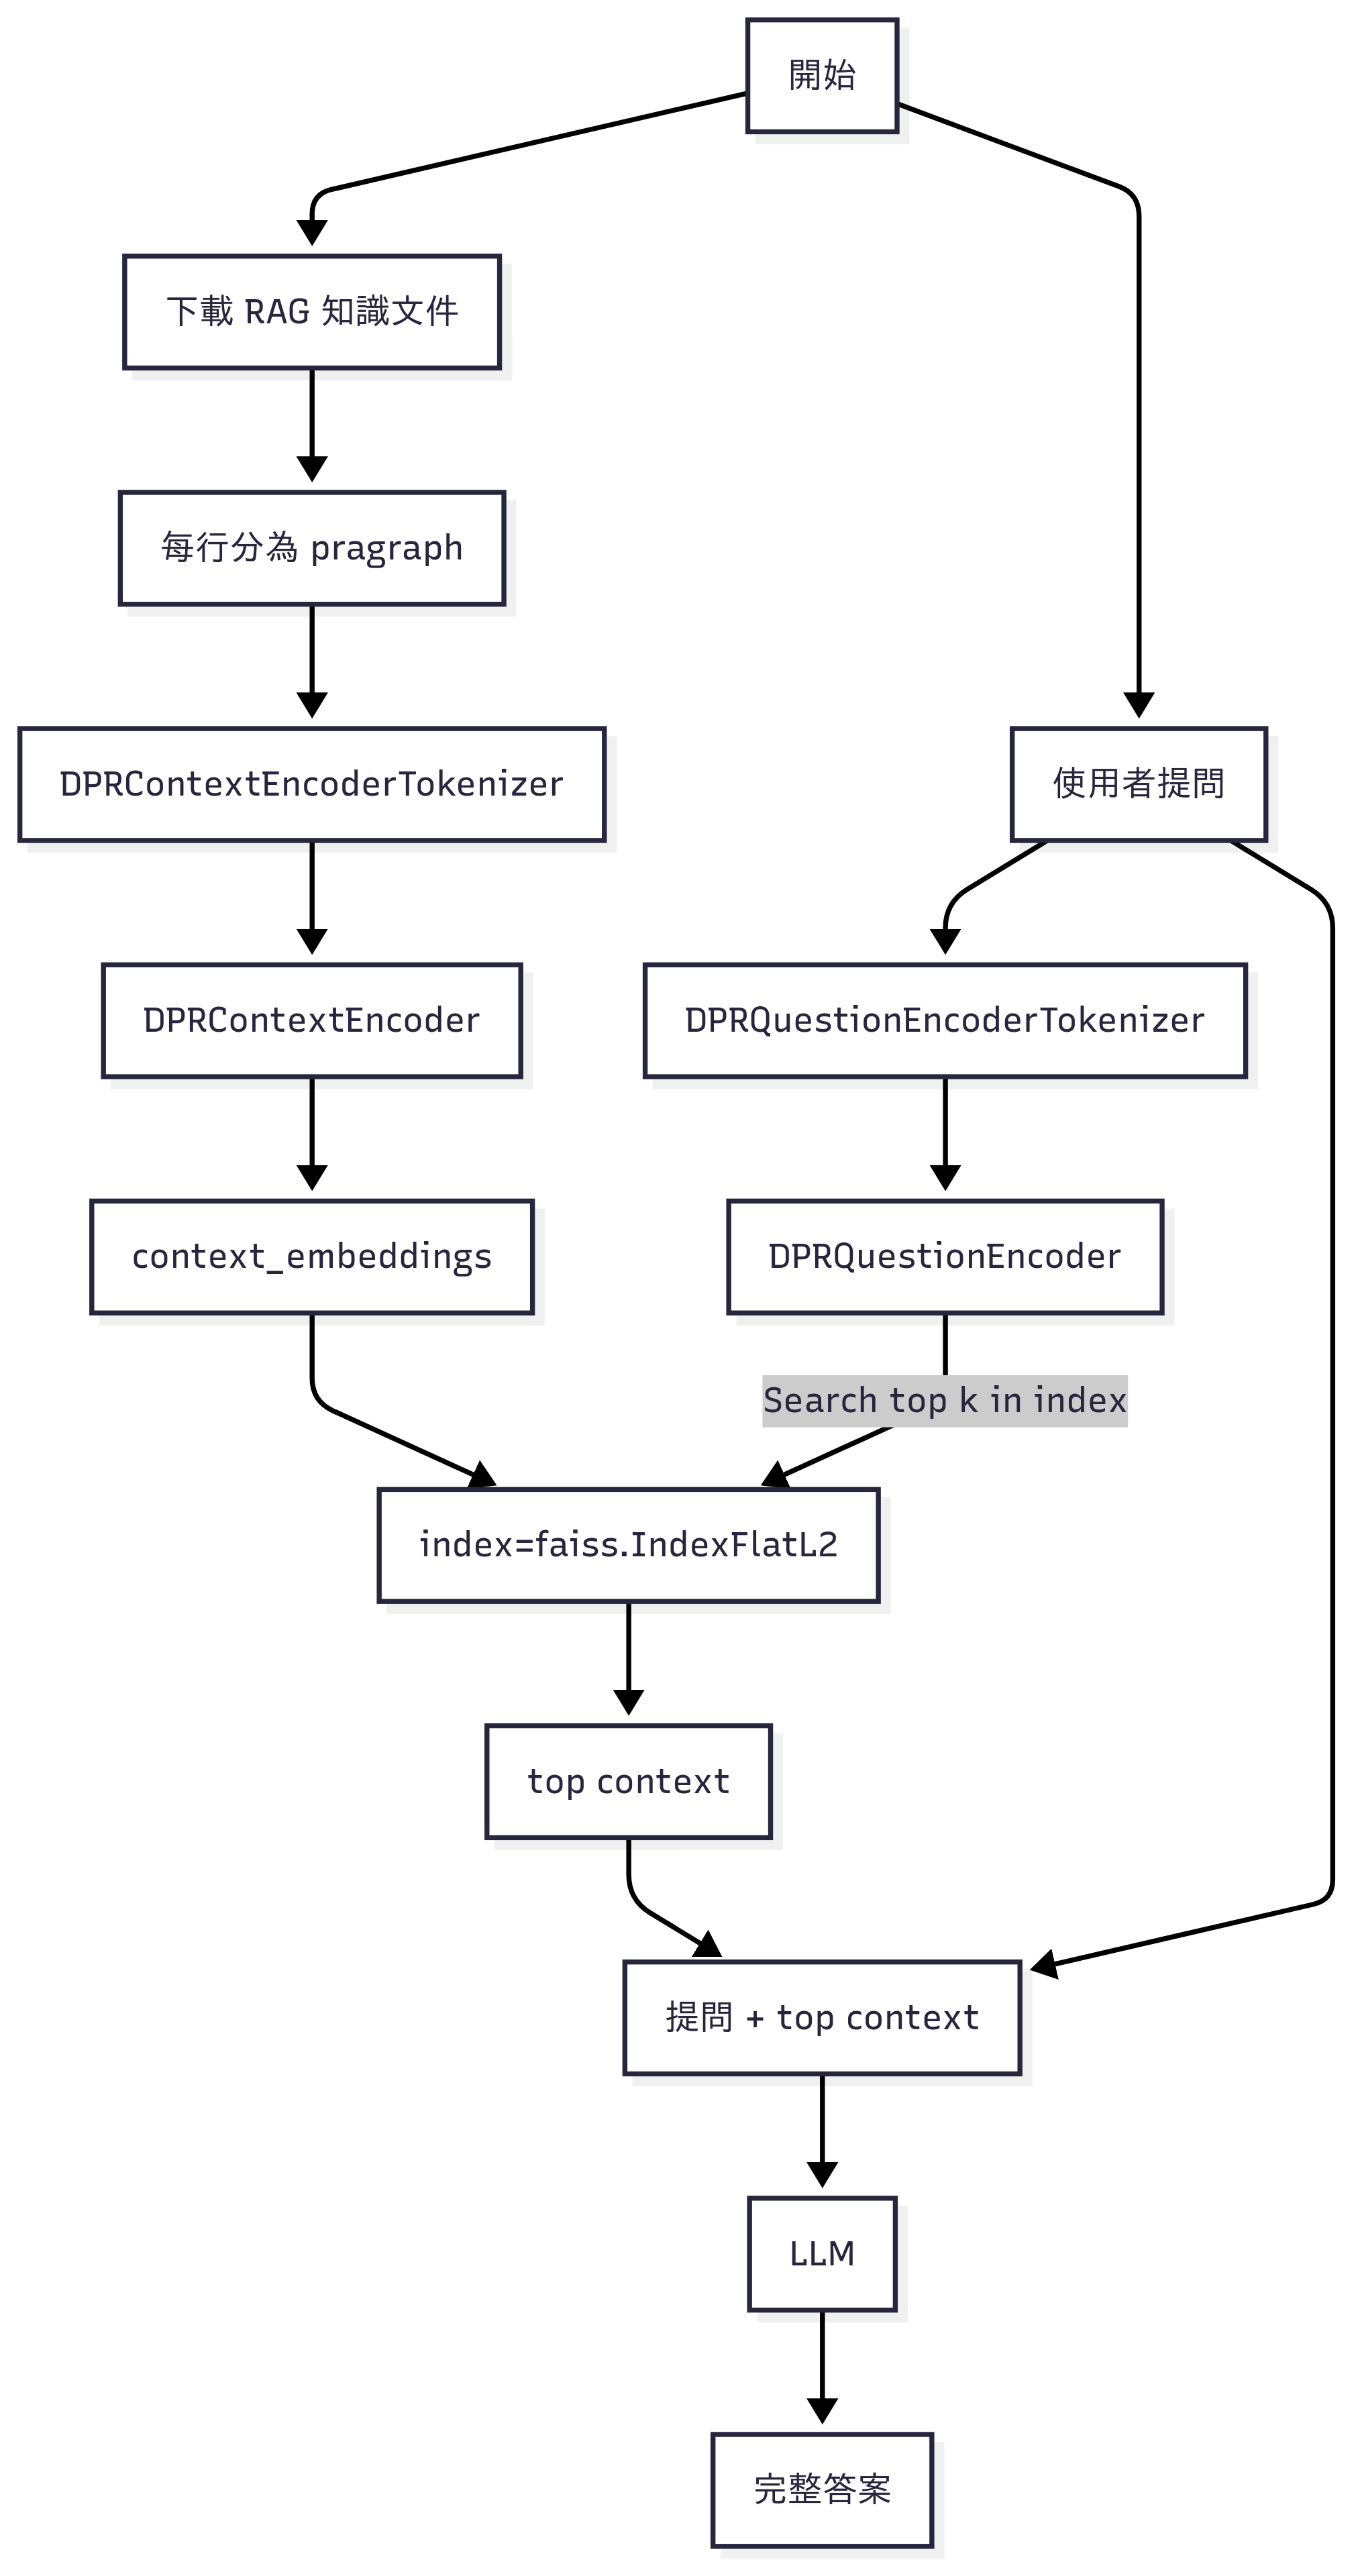
    基本上 RAG 的知識庫可能是一本書、一本使用手冊、一堆 Facebook 的用戶資料等等。它們先分為不同的小段落,然後 tokenize,每個段落再 encode 為一個向量。同理,對使用者提問也做同樣的事,但此處理解為只產生一個向量。

    由於知識庫的向量筆數很多, FAISS 為他們製作 Index。提問的向量用 FAISS 的函數中找出最接近的幾筆最相關的向量,再根據 index 反查出 text 原文。然後把 text 和使用者提問合在一起去問 LLM。

    對 LLM 來說,它可以有自己的 tokenizer。總之,RAG 已經功成身退了。

    假如不用 FAISS,純靠 Pytorch 的話,那麼要自己用 dot product 去比較相似性。因為每個 word 就可能對應到一個高維的 token,所以每個 pragraph 的向量就是所有組成 pragraph 的 word 的向量的平均值。

    最後補充 DPR (Dense Passage Retriever)。顯然,它對於 question 和 context (passage) 用了兩套函數 – 所謂 dual encoder [1]。我們可以想像,對於 question 的編碼應該要力求精準,但是對於參考文件這部分,如果是一本百科全書、或是整個資料庫,那編碼時主要是求快!所以兩邊的編碼方式不太一樣、甚至 tokenizer 不太一樣 (但是相容) 應該也是合理的。

    [REF]

    1. https://blog.csdn.net/qq_45668004/article/details/138256448

    LoRA 小複習

    LoRA = Low Rank Adaptation, 先前也提到過這個 fine tuning 的技術. 本來想好好複習一下, 但這次看的 IBM 課程真的速度太快了. 為了確定我在幹什麼? 我決定來整理一遍今天 Lab 的成果.

    本課程使用 AG News (新聞) dataset 訓練出來的 model, 希望把它調整為適用於 IMDB (影評) dataset. 兩個 dataset 的性質不同, label 也不同. 前者的 label 是把所有的新聞分為四個類別:世界新聞(World News)、體育新聞(Sports News)、商業新聞(Business News)和科技新聞(Technology News)。後者是把所有的影評分為正面情緒和負面情緒兩類.

    現在我們要把 model 從適用於 AG News 分類, 改為適用 IMDB 分類, 並且儘量借用已經訓練好的文字理解能力. 當然原本的四類輸出就不能用了, 我們要攔胡中間的成果, 將它重新分為兩類.

    首先課程會安裝很多 lib, 這點做得比 Google 課程好. Google cloud platform (GCP) 不是為教學而生的, 自己猛進版, 然後課程的版本會慢慢變得跟 GCP 不相容, 解答版都有 pip error, 做個 Lab 還要解決相容性問題. IBM 這邊沒有這個狀況. 只是課講得超快, 我都要放 0.75 倍才聽得懂, 而投影片則是會一閃即逝, 沒學會速讀都不知道看到啥了.

    總之, 基本的東西都安裝定義好之後, 下載 IMDB dataset, 分為 train 和 test 兩部分, 前者隨機抓 95%, 後者抓剩下5%.

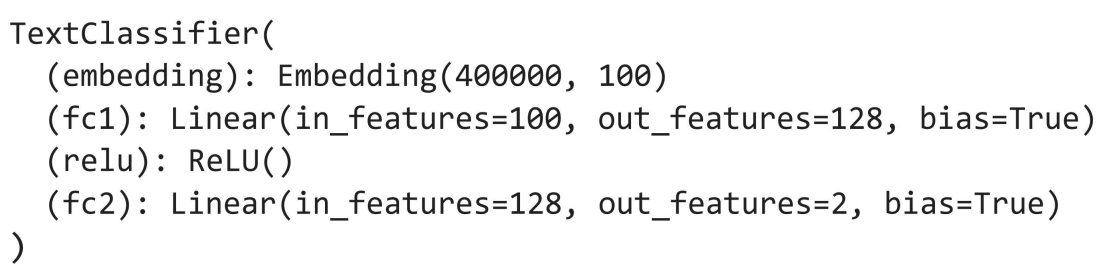
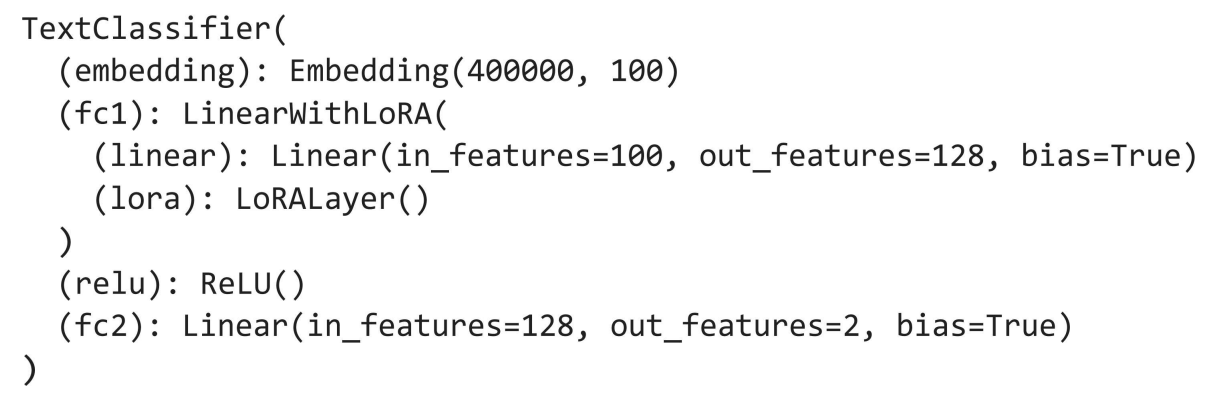
    接下來定義一個 IMDB 適用的 mode, 將詞彙表中最多 400,000 個詞彙轉換成 100 維的向量表示(Embedding), 接著經過 2 個全連接層 (FC1, FC2) 和中間夾的 RELU. 如果沒有非線性層, 根據線性代數, 不管幾層都可以等效為一層. 所以這邊每層的 node 為 100 –> 128 –> 2.

    我們把這上面這個簡單的 model 拿來訓練 IMDB dataset. 為節省時間, Lab 只跑 2 個 epoch. 不過可以看到跑 300 epoch 的結果, 正確率 66.176%. 其實這個部分跟 Lora 還無關.

    接下來開始做 AG News re-trained model, 它的模型只有輸出是 4 個 classes. 其他和前面一樣.

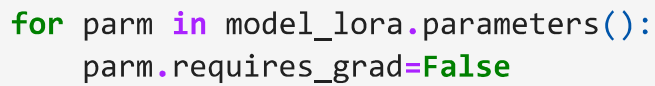
    為了準備後續的 LoRA, 先把這個 mode 叫做 model_lora, 且設定為 gradient 不更新, 也就是 parameter freeze. 包括整個 neural network 和 embedding layer.

    把 LoRA 放進 AG News model 的版本, 首先在 FC1 後面加上 LoRALayer(), 很顯然地它的輸入是 128 個 node, 輸出也是 128. 還有呢, 輸出的地方也配合 IMDB 改成 2 個 classes 了.

    然後我們用 IMDB dataset 訓練這個 model_RoLA, 因為前面的 parameter 都 freeze, 所以真正訓練的是 LoRALayer() 到 FC2這一段. 訓練完 300 個 epoch, 正確率來到 69.156%. 也就是說藉由 AG News pre-trained model 的加持, 在其他條件不變的狀況下, 效果提升 3%. 而且沒有動到 AG News model FC1 的參數.

    故事還沒有結束. LoRALayer 是一個低階數的連接層. 它相對於原來的網路是多出來的. 數學上理解為參數的調整. 原本的 h(x) = Wox. 其中 W 是參數矩陣, x 是輸入向量, h 是輸出向量.

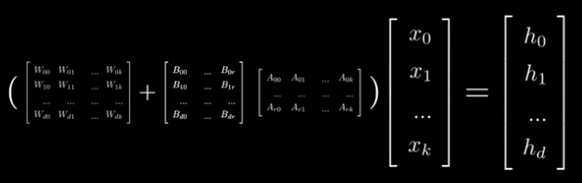
    有了 LoRA 之後, h(x) 當然還是 Wox 的函數, 而且這部分不能動. 能動的部分就是多了 ΔWx. h(x) = Wox + ΔWx.

    而 ΔWx 又表現為 B 和 A 兩個低 rank 的矩陣. 甚至是 d * r 乘 r*k 中的 r = 1這麼 “low", 只要乘出來是 dxk, 就可以和 Wo 相加了. 當然 r 低得太誇張效果可能不好.

    對於訓練過的新 model, 我們只要存 B 和 A, 其它可以套用既有的 pre-trained model. 上面的例子中因為 FC2 也變了, 所以就不能只存 B 和 A.

    walk through 範例之後, 完整的課程還要做一個 excise, 這樣總共只給一小時, 真的太看得起我了. 不過其實 IBM 的課很佛心, 只要繼續用, 它就不會把你踢掉.

    反觀 Google 的課程都有倒數計時, 明明時間都是被它自己雲端吃掉的, 只要時間一到就關門了. 想要拿到 credit, 只能靠瘋狂執行 “run all cell" 來搶時間, 其中需要手動改的 code, 更新 tool 版本的 script 都先存好, 趁前面還在安裝中, 後面找 cell 貼 patch, 才能避免一再"重修"~~還好噩夢已經過去了.