我讀 «會賺小錢才厲害»

其實這本書是我順便買今周刊的時候送的, 趁著放年假把它讀完.

本書的作者是媒體人程琳, 而本書就是她 (?) 所接觸到的一些小人物的故事集. 關於作者, 我很想確認一下她的資料, 不過我連她的性別都無法確定? 因為只要到 Google 去搜尋程琳, 不是找到一個正妹, 就是一個大陸歌手. 而本書的作者好像不是其中的任何一位. 既然兩位程琳都是女性, 我就先假設作者是女生吧!

本書的前言很吸引人, 她講了一個小故事. 英國維京集團的創辦人理查布蘭森 (Richard Branson) 在經濟不景氣的情況下打算提升機艙內影片娛樂設備. 不過這麼一來得花上 1,000 萬美元. 不過景氣不好的時候, 融資也相對困難, 布蘭森籌不出升級的這筆費用. 於是布蘭森打電話給波音, 聲稱要買十架波音的飛機, 並且要求對方附送升級的影音設備. 既然經濟不景氣, 波音同樣需要這筆訂單, 當然慨然同意這筆買賣.

接著布蘭森再找上空中巴士比價, 兩方競爭之下, 維京果然獲得更大的折扣. 但是, 連升級豪華套餐的錢都沒有了, 還有錢吃 buffet? 布蘭森買飛機的錢要從哪裡來呢?

這個關鍵點應該是買飛機有抵押品, 但是升級飛機卻沒辦法變成抵押品. 既然有飛機擔保, 又是鉅額的借款, 維京和銀行的生意就談成了.

作者藉著這個小故事告訴我們, 天無絕人之路, 只要多動腦筋, 就可以找出生機. 在這本書裡面的故事, 大多不脫這個範圍, 只不過裡面沒有總裁或是創辦人, 而是由你我身邊的老百姓擔綱主演.  像是自己種菜, 當配音員, 做街頭表演, 幫 A 片塗馬賽克, 在殯儀館伴奏, 為藥廠試藥, 替人跑腿, 代客照顧寵物, 幫往生者修補大體…等等. 不論只是兼差賺錢, 或是賴此維生, 只要肯動腦筋, 自然可以找出生機, 不一定得從事擺攤販, 開計程車, 賣雞排等等人盡皆知的行業!

這本書的結語也不錯 . 一般的上班族在職場上歷經 N 年的奮鬥之後, 只有少數人可以功成名就, 大部分的人都會被請下電梯. 眼前的電梯沒得搭, 只好另換一部電梯啦! 要是什麼電梯都找不到, 總不能一直等下去. 我們就改走樓梯吧!  無論樓梯可能多麼難走, 畢竟這是一條自己的路. 只要能登上心中的屋頂, 也就沒有遺憾了. 

我讀 «真希望老師這樣教統計»

如前面幾篇所寫的, 這是兩位日本人菅民郎和土方裕子, 譯者是李佳蓉小姐.

這本書的開頭相當輕鬆, 比方說它介紹了數據的類型, 哪些是可以統計的, 哪些是不能統計的 (比方血型的平均值).

接著由淺入深, 講到如何統計算標準差, 以及統計中會遇到的誤差. 後面幾章還講到了如何設計與解讀問卷.

以牙醫診所的滿意度為例, 我們可以用問卷問各種問題, 並且計算出一個綜合評價. 假如某個項目的分數與綜合評價的相關係數高, 那麼就表示這個是客戶所特別重視的. 此為分析圖的 X 軸. 而 Y 軸就是各個單項的滿意度.

顯然, 待改進的項目落在右下角的區域. 它與綜合評價相關, 而單項滿意度又偏低.

最後本書教大家用 Excel 實做簡單的統計函數, 以及複雜的多變量分析. 我跟著做了一遍以免以後就懶了~~~ 這本是很不錯的書!

樣本比率的統計

前次提到取樣的比例太低時, 樣本誤差需要做修正. 當時的隨機變數是一個數字, 所以它有平均值的概念. 那麼隨機變數如果是一個比例呢? 例如紅豆在八寶粥當中的比例是多少? 所有的紅豆集合起來才能貢獻出一個隨機變數, 因此就沒辦法算出平均值或標準差了.

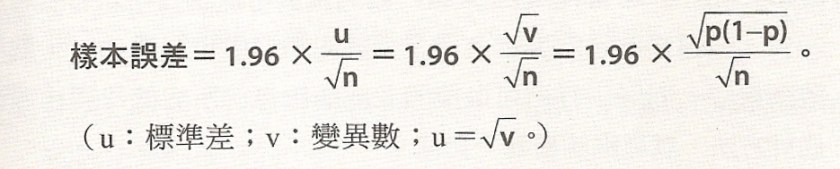
此時, 我們假設樣本數 n, 樣本中呈現的比率 p, 樣本誤差 D. 那麼在母體當中的比率, 可以用 p ± D 來表示. 而書上說 D = 1.96 x sqrt (p(1-p)/n).

換言之, 若我們舀了一匙的八寶粥, 裡面全都是紅豆, 或是半顆紅豆都沒有; 則 p(1-p) 肯定是 0, 樣本誤差 D = 0. 這表示我們就得相信我們買到的七寶粥 (少了紅豆), 或是一寶粥 (只有紅豆). Well, 這好像是公式的 bug.

它的理論可以從這裡找到支持. 假設標準差為 µ, 它的平方為變異數 v. 書上說:

換言之, 不要把 p 看做單一的值, 而是一個二值化 (0 or 1) 數列, 一種類型數據, 的平均值的話. (1-p) x p 就像 0 與 1 在對均值 p 計算離均差. 而變異數 v 又是離均方差的平方和的期望值 (平均值). 因此兩者的確很類似.

當然, 上次講到的修正值在比率分析中也是有效的. K = sqrt((N-n)/(N-1), N 表示母體的全部樣本數.

我還漏掉一個東西沒寫, 那就是精確度 (相對誤差), 它等於樣本誤差除以 p (比率) 或是上次的 m (平均值). 個人覺得相對誤差的意義不大, 理論基礎以後再討論.

了解了樣本誤差之後, 當我們再看到政策的支持度由 33%, 降到 27%, 再降到 25% 的時候, 要記得把每個數字都加減樣本誤差, 以得到一個 “母體比率信賴區間".

如果三次民調的信賴區間是重疊的, 那麼我們可以認為三次民調的意義沒有差別. 如果兩次民調和另外一次民調的信賴區間沒有重疊, 那麼它的效力就等於兩次有效的民調. 若三次都沒有重疊, 那麼支持度就真的持續下降了.

以上整理自 “真希望老師這樣教統計".

如何利用樣本做估計

假設我想知道整家公司的平均體重, 那麼只用一個部門來估計準不準呢? 答案是不準, 因為我們明明知道庶務二課或是秘書課的人都不胖, 所以據此估計出來 “滿帆商事" 的平均體重就會有點誤差. 這不需要數學好就可以知道.

反之, 如果根據一把抓起的豆子重量, 來估計一整桶豆子的重量範圍, 相對就比較準確了.

假設一把抓的豆子總共有 n = 100 顆, 平均數 m = 1g, 標準差 µ = 0.1g. 若整桶豆子約有 N = 10,000 顆, 可計算出樣本誤差 D = 1.96 x µ / sqrt(n) = 1.96 x 0.1 / 10 = 1.96 x 10⁻².

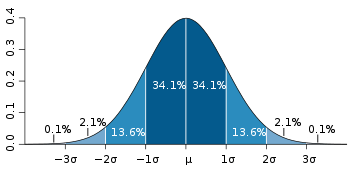
為啥是 x 1.96 呢? 因為假設重量為 N(0,1) 的常態分佈, 在 95% 的範圍內, 標準差為 1.96. 當樣本數很大, 樣本誤差趨近於 0; 反之樣本數為 0 的時候, 樣本誤差趨近於無限大. 如果只有一個樣本, 樣本誤差大約是 2 倍 (1.96 倍) 標準差.

[本圖取自 WIKI 標準差]

換言之, 我們認為那桶豆子的平均重量為 m – D ~ m + D 之間, 也就是 1 – 1.96 x 10⁻² ~1 + 1.96 x 10⁻² 或 0.9804~1.0196 g.

或曰, 怎麼和整桶豆子數量級 N 無關? 如果以井觀天, 以蠡測海, 也是用這個公式嗎? 非也, 這時候樣本誤差 D  還要乘上一個修正值 K = sqrt ((N – n) / (N – 1)).

把 Dnew 重寫一次得到Dnew = 1.96 x µ x K / sqrt (n).

直覺地說, 當 n 趨近於 N, 表示我一把已經把豆子抓光了, 那麼誤差應該修正為 K = 0 與 Dnew = 0. 因為 Dnew = 1.96 x µ x K / sqrt(n) .

如果真的由井底蛙來估計天空的大小, N >> n 將使得 K = 1. 因此我們知道 K 介於 0~1 之間,

為了抓一個手感, 我們假設 K = 0.49 的話, 則 N – n = 0.7 x (N -1), 0.3N = n – 0.7. 假設 N 和 n 都比較大, 那麼 n > 0.3N 是必須的. 也就是說, 想要讓修正值 K < 0.5, 那麼好歹得一把抓起 3 成的豆豆.   

以上整理自 “真希望老師這樣教統計".

變量之分析

和多變量分析相對的, 是較簡單的單變量分析, 線性迴歸分析即為其中的一種. 假設我們有一群 X 和一群 Y. 而兩者有這樣的線性關係:

Y = a + bX

那麼只要算出 a 和 b, 我們就可以用 X 求 Y, 或是用 Y 求 X 了. 計算 a, b 的步驟如下:

1. 計算 X 與 Y 的平均值 XY.

2. 計算 X 的離均差平方和. SUM (Xi X)2

3. 計算 Y 的離均差平方和. SUM (Yi Y)2

4. 計算 X 的離均差 x Y 的離均差的和 = 離均差交乘積

SUM ((Xi X) x (Yi Y))

5. 計算

b = 離均差交乘積 / X 的離均差平方和

= SUM ((Xi X) x (Yi Y)) / SUM (Xi X)2

a = Y – b x X

至於多變量要怎麼分析呢? 最簡單的方式就是用 Excel.

以上摘自 "真希望老師這樣教統計", 作者是菅民郎和土方裕子.