在講點正經的之前,先講點不正經的。這週受到 AI 供應鏈教父 女色 的影響,股票跌出了新高度。反正長期持有就是這樣,資產慢慢累積,振幅也會跟著變大。這次在 11/5 累積跌 8.26%,單日跌幅也達到最多位數;現在受惠於台幣貶值,已收復不少失土。據說台幣會跌一陣子,所以數據會有所美化。
這有讓我頓悟什麼嗎?沒有。所以我來講講頓悟有什麼跡象。
假設我們有一個會計算 mod 97 的 AI model,包括普通的 embedding 層、Transformer 層、和 FFN / MLP 層。顧名思義,它學會 2+96 後就會輸出 1 ,因為 mod (2+96)=mod (98) = 1。
當我們把所有 0~96 和 0~96 的組合都送進去測試,會有 9,409 種組合,如果每題都答對,當然 model 就算學會了。但是這個 model 是在哪一步開始頓悟加法的真諦?或是純粹就是靠死背呢?我很好奇,更發現其他人已經有大量的研究了。我就算晉身此界也是師弟,當不了師叔。
想像一個有 97 格的環。被加數站在 96,再向前走 2 格代表加數,結果會回到 1。對加法而言,把數字 a 放到角度 2πka/97,加 b 就像再轉 2πkb/97。這裡的 k 是你選擇繞環的頻率。若寫成複數波 exp(2πika/97),輸入平移 b 格,頻域只需乘上一個相位因子;也就是訊號處理課教的循環平移。這樣就解釋了加法。
我訓練了一個 1 層 transformer 來做 (a+b) mod 97,訓練集佔 50%。大約 5,000 步後測試準確率從約 49% 升到 100%,也就是 grokking。示意程式由老馬 (斯克) 的 Grok Bot 提供,叫 Grok 研究 Grokking 正好。
import numpy as npdef embedding_spectrum(W_E): # 沿 token 軸做長度 97 的 DFT F = np.fft.fft(W_E, axis=0) # 97 x d power = np.linalg.norm(F, axis=1) # 每個頻率在模型維度上的能量 return power[1:49] # 頻率 k 與 97-k 成對,只看 k = 1..48def gini(x): x = np.sort(np.abs(x)) n = len(x) return (2 * np.arange(1, n + 1) - n - 1) @ x / (n * x.sum())spec = embedding_spectrum(W_E)print("Gini:", gini(spec))print("能量最大的 5 個頻率:", np.argsort(spec)[::-1][:5] + 1)
頓悟後,我們可以看到下圖左有五根紅棒特別高。這意味著 model 學到五組頻率後 (由隨機種子決定),大概就對加法之道運作自如了。此處是用 Gini 法評估,把 embedding 各頻率的能量排出來,看是少數頻率吃掉大部分能量,還是大家平均分。下圖右在 4200 步附近頓悟,有那種突然醒過來的感覺。
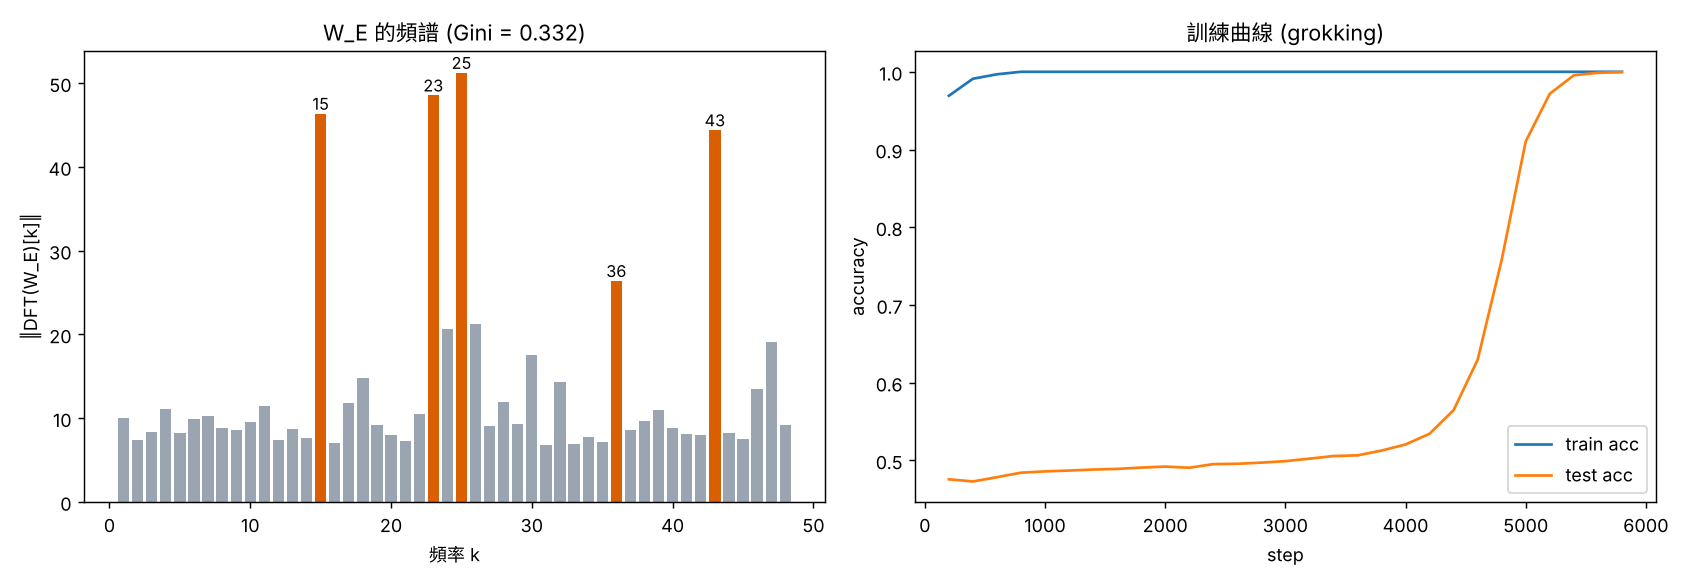
此案例中,Gini 只有 0.33,不算高。因為 48 個頻率裡只有 5 個突出,其餘不是零,底噪偏大。如果想看「稀疏度」,也可以只算峰值佔總能量的比例。其他實證的手法比較厚工,包括:
- Excluded loss:把模型認定的關鍵 Fourier 成分從 **logits(輸出分數)**拿掉,再用訓練題算損失。若移掉後訓練損失變高,表示這些成分確實在幫忙。
- Restricted loss:反過來只保留所選的 Fourier 成分,其他拿掉,看看留下來的部分能不能解題。
以上的說明,對於加減法都適用。那乘法呢?Furuta [4] 等人在加法基底下分析模乘,觀察到許多頻率都參與;後來 Nguyen [5] 用另一組基底重新檢視,發現他的模 113 模型其實有稀疏結構。
這裡要補一個關鍵字:原根(primitive root)。對模 97 而言,5 是一個原根。意思是從 1 開始不斷乘 5、或曰計算 5 的 j 次方,每次再取除以 97 的餘數,會在回到 1 之前,剛好走遍 1~96 每個非零餘數一次。前幾步是:5^0 mod 97 = 1 → 5^1 = 5 → 5^2 = 25 → 5^3 = 28 → 5^4 = 43 → … → 5^96 mod 97 = 1。
上面那串不是把數字由小排到大,而是把「乘以 5」這個動作排成一個 96 格的環。零不在裡面:零乘多少次都還是零,必須另外處理。因為每個非零數都能寫成某個 5^j mod 97,我們可以反過來把它標成 j;這個 j 就叫 以 5 為底的離散對數(discrete log)。
例如 25 的標號是 2,28 的標號是 3。現在再看乘法:如果 a=5^i、b=5^j,那 a×b mod 97 = 5^(i+j) mod 97。乘法在這個新編號裡變成指數相加(mod 96)。
故這時先把 embedding 的非零數字列按 1,5,25,28,… 重新排列,再做長度 96 的 DFT,就相當於用乘法群的 Fourier 基底看它。Nguyen 在 mod 113 的模型上報告:原本的加法 DFT 看起來很分散;改用離散對數排序後,Gini 從 0.07 左右到 0.58 左右,而且只剩幾個主要頻率。很酷吧!
當然,有道德感的 AI 會吐槽我有邏輯漏洞,所以我必須多講幾句,免得天網把我列為難相處的對象,進而斬殺。
- 兩種電路都可能解同一題。 Zhong [1] 等人發現模加法可以長出 Clock,也可以長出 Pizza,甚至更複雜的程序。嵌入有規律,不代表你已經知道後面是哪套演算法。
- 關鍵頻率常是事後找的。 如果先看最終模型再回放中途 checkpoint,就不是一個完全不看答案、事先固定的偵測器;真正要預測新模型時,頻率選擇和門檻須先鎖定 [2]。
- 稀疏不是必要條件。 某些模型的解法可能分布於更多頻率;單看 Gini 低,不能叫人家「沒開竅」。Gromov [3] 對不同模算術任務提供了可解析的兩層網路解,正好提醒我們別把某一種 Transformer 頻譜當定義。
- 表示的基底會改變結論。 加法 DFT 不是乘法的萬用眼鏡,原根與離散對數是為了把乘法的結構對準。[4][5]
- 頻譜分散有很多原因。 在還沒 grok 的模型上看到分散的頻譜,可能是還在背題,也可能只是電路還沒長出來,不能直接讀成「這個模型學不會」。反之,也不能在 training 過程中,只看到一點跡象就猜它頓悟了。
最後,對於好學不倦有始有終的網友們介紹除法。a/b = a * b-1。先找出 b 在模 97 下的乘法逆元 b⁻¹,再計算 a * b-1(mod 97) 即可。由於 97 是質數,除了 0 以外,1 到 96 的每個整數都保證存在唯一的模逆元。 至於找出模逆元的方法有費馬小定理 (Fermat’s Little Theorem)、擴展歐幾里得演算法(Extended Euclidean Algorithm)、查表法 (本人真心推薦,可以減少人腦強化學習後,所造成的崩潰或災難性遺忘)。
[REF]
- Zhong, Liu, Tegmark, Andreas (2023). The Clock and the Pizza
- anda, Chan, Lieberum, Smith, Steinhardt (2023). Progress measures for grokking via mechanistic interpretability
- Gromov (2023). Grokking modular arithmetic
- Furuta, Minegishi, Iwasawa, Matsuo (2024). Towards empirical interpretation of internal circuits and properties in grokked transformers on modular polynomials
- Nguyen (2026). The Discrete-Log Clock
- Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets — Power et al., 2022

