YOLO V3 + Tensorflow V2 小筆記

去年我寫了一個專利, 到現在專利事務所還沒完成申請流程, 這樣我就不能公開啦! Anyway, 我來研究實作技巧吧.

首先, 我需要 YOLO V3. 前幾年研究的 Facenet 是用 Tensorflow 1.10, 現在上網一查, 人家已經用 Yolo V3 搭 Tensorflow V2 [1] 了. 首先需要 TF V2 [2]. 然後用上次的老招升級成 tensorflow-gpu

pip3 install --ignore-installed --upgrade tensorflow-gpu

此時遇到下面 error

distributed 1.21.8 requires msgpack, which is not installed.

用 pip3 install msgpack 解決.

接著在 Yolo V3 的安裝過程中, 需要多安裝 git for windows, 這可以參考 [3]. 至於 wget 在 Anaconda3/Lib 底下有.

一切搞定後, 進入 Anaconda3 的 TF2 (自己取的) 虛擬環境, 進行 Yolo v3 的訓練. 此時會報一個錯. 

File "C:\AI\Anaconda3\envs\TF2\tensorflow-yolov3\core\config.py", line 14, in <module>
from easydict import EasyDict as edict
ModuleNotFoundError: No module named 'easydict'

這時只要安裝 easydict 就好, 就可以堂堂跑 Yolo V3 了. 看樣子也真的有去找 GPU.

PS C:\AI\Anaconda3\envs\TF2\tensorflow-yolov3> python train.py
2020-03-04 23:31:09.283568: I tensorflow/core/platform/cpu_feature_guard.cc:141] Your CPU supports instructions that this TensorFlow binary was not compiled to use: AVX2
2020-03-04 23:31:10.297903: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1411] Found device 0 with properties:
name: GeForce GTX 1050 major: 6 minor: 1 memoryClockRate(GHz): 1.493
pciBusID: 0000:02:00.0
totalMemory: 2.00GiB freeMemory: 1.61GiB
2020-03-04 23:31:10.345495: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1490] Adding visible gpu devices: 0

接下來就是去洗澡, 看要多久才會 train 完. 可是, 六分鐘護一生之後, Python 把環境建好, 開始讀檔案要 training 時就出錯了. 原來是個豬頭 bug 把路徑名稱寫錯, 這題還研究了半天, 以至於學會了 os.path.normpath, os.path.join 的用法…

重新起跑後不久, 又遇到了 memory 不足的問題:

OP_REQUIRES failed at gpu_swapping_kernels.cc:72 : Resource exhausted: OOM when allocating tensor with shape[1024] and type float on /job:localhost/replica:0/task:0/device:GPU:0 by allocator GPU_0_bfc

這算是老問題了. 我的 Notebook 只有 2GB GPU RAM, 普通的 Yolo V3 要 4GB DDR, 所以應該要用 tiny 版本的 Yolo 才有機會. 此時找到 [4] 這篇滿實用的, 介紹得很清楚, 每個 model 要用多少 GPU RAM. 雖然它是用 Darknet, 但也有豐富的連結到其他 framework. 因此下一篇我將轉往 CPU only 或 Yolo Tiny 的方法.

另外就是下次買 Graphic card 做 AI 實驗, 內建 GDDR 的大小的重要性遠勝過計算能力. 能夠有 4GB free 就可以, 因此最好是內建 6 GB 吧, 不然就是要兩張卡了. 兩張卡的用法可以參考 tensorflow 官網 [5].

ˋ[Note]
  1. https://github.com/YunYang1994/tensorflow-yolov3&nbsp;
  2. https://medium.com/@shaolinkhoa/install-tensorflow-gpu-2-0-alpha-on-anaconda-for-windows-10-ubuntu-ced099010b21
  3. https://gitforwindows.org/
  4. https://gitee.com/suiyifan/darknet
  5. https://www.tensorflow.org/

我讀 «證券分析» 第六版 – 完結篇

本書有個第八部分, 標題叫做 “環球價值投資". 事實上, 作者並沒有討論過怎麼投資海外的股票, 所以這個部分只有一篇導讀. 導讀寫得還不錯, 主要就是認為本書的觀點可以用在全世界的股票.

想要買海外的股票當然會遇到很多困難. 像是匯率風險、會計制度不同、股息被扣稅遲遲無法退稅、資訊不透明 (特別是未上市公司)、無法獲得投票權…等等不一而足. 但導讀人 Thomas Russo 舉了自身的例子給大家參考.

想投資韓國樂天糖果: Russo 問公司高層明年現金流的前景如何? 翻譯和高層講了 30 分鐘, 翻譯結果只有 “更好" 而已, 因此放棄不投資. 想投資荷蘭海尼根, 副主席很嚴肅地問他 “你在這裡幹什麼?" , 非常好奇為何美國人會想跑來投資. 想投資英國維多麥 (Weetabix), 買了16% 的股份, 還花了好幾年才能見到 CEO 一面. 上述兩家都是家族企業, 他們專注本業、注重回饋股東, 故 Russo 也想辦法讓自己能參與經營. 

最後本書有個附錄, 高達百餘頁 (P.823~924), 但我決定跳過. 這部分有被收錄在電子掃描檔, 故顯然大家公認它比第八部分更有料. 裡面的表格確實非常多, 我想可以視為個案分析的一個資料庫. 這個單元跳過不算的話, 我已經把整本書都摘錄完了. 若是有人說沒讀完附錄不算讀過 “證券分析", 那我也只好投降輸一半了. 謝謝收看!

我讀 «證券分析» 第六版 – 市場分析與證券分析

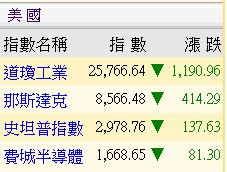
昨晚 (2020/2/27) 道瓊指數大跌 1190 點, 寫下歷史紀錄. 這種大日子當然值得剪報留念.

usa-historical-fall

然後讀點書來壓壓驚. 

第 52 章講市場分析與證券分析. 無疑地作者當然認為自己是證券分析師, 並且鼓勵大家做證券分析師. 假如我們認真地做市場分析, 而非主觀的臆測, 那麼市場分析有時能夠替代或是輔助證券分析. 畢竟 “掌握買賣時機或是選擇上漲最多、最快的股票的技巧, 顯然要比費力研究股票的內在價值帶來更豐厚的利潤 (p. 800).

市場分析可以分為兩類: 第一類只從股票市場的歷史表現中尋找資料來進行預測. 我想大家比較熟悉的講法叫做 “技術分析", 本書中叫它做 “圖表法". 第二類分析關注所有的經濟因素.

本書既然是價值投資的經典, 當然不可能大推技術分析. 因此 p. 802 講到:

  1. 圖表法不可能是一門科學.
  2. 並不存在一種可以保持長期預測準確性、同時又被眾人所知的圖表法. 只要大家都用某個方法, 它自然就會失效.
  3. 理論基礎有待商榷. 雖然我們可以精準分析過去, 但預測未來這件事未必能幫投資人賺錢. 雖然證券分析同樣是研究過去的數據, 但是證券分析強調用 “安全邊際" 來保障自己, 市場分析卻否認 (需要安全邊際) 這一點 (p.803).
  4. 技術分析中的停利停損會產生保護作用, 讓投資人不致損失太大並且獲得一些成果. 但頻繁進出、或是與大多數股民同進同出, 使得獲利進一步地受限.

第二類的市場分析法只看經濟數據, 例如以前看高爐 [1] 開工率、現在看用電量. 或是最近依然當紅的 “殖利率倒掛" 這些指標. 本書批評機械指標 (mechanical indices) 不夠科學的地方在於, 它只能定性預測, 不能定量預測. 例如股市會走低, 但是會多低、低多久? 如果不能提供對應的數據, 還不能算一門科學.

總結起來, 證券分析勝過市場分析:

  1. 證券分析有安全邊際, 市場分析只有對或是錯.
  2. 市場分析的停利停損增加交易成本. (當然現在有免傭金的證券公司, 這個問題就不存在).
  3. 市場分析是零和的鬥智遊戲. 只有幸運者能占其他人的便宜.

市場分析若要增加自己的勝率, 多少要做證券分析, 確保股價低於內在價值, 而不是預測股價會高於現值.


這一章的後半部 (P. 808~P.812) 開始轉換討論的重點, 不討論分析師採用哪種策略去分析, 而是討論投資人應該用哪種策略? 投資人可分為兩類: 有錢的跟沒錢的. 嗯, 資金多的跟資金少的.

A. 資金少的投資者, 又分成 3 類, 依據他們重視什麼而定:

  1. 收益型投資者: 適合買美債. 當然這是指美債利息很高的年代. 作者認為國債才能保證收益, 其他儲蓄商品、甚至是股票都不夠可靠.
  2. 利潤型投資者: 作者認為他們其實是想達到證券分析師想達到一樣的目標. 但叔叔才有練過, 因此書上建議投資人應該接受專業分析師的批評. (P. 809)
  3. 投機型投資者: 本書一貫認為, 購買股價低於內在價值的證券才是投資, 即使用過高的價錢買進 “成長型股票" 都算是投機 – 這已經算是比較有勝算的方式. 其他的投機行為包括創投、購買未上市、新上市、或者看起來上漲的股票都算. 這些的勝率都非常低, 需要非凡的聰明才智和運氣.

B. 資金較多的投資者, 顯然資金較多的投資者擁有明顯的優勢, 但也有三個劣勢, 前兩個我看不懂.

  1. 購買國債有數量限制. (P. 811)
  2. 通膨對他們的影響比較大.
  3. 只好投資在規模夠大的標的, 對發掘低調又優質小公司容易有偏見.

其實本書又花了一兩頁講企業和金融機構的投資. 對於企業而言, 本書依然建議買美國政府債券. 對金融機構, 作者說他不敢冒昧建議, 但是如果債券、優先股 (書上翻譯是: 高等級固定收益證券) 的收益對它們已經足夠的話, 他會建議就不要去買普通股的股票了. 如果認為這樣還是抵抗不了通膨, 可以用一部份的資金, 基於證券分析的標準和技巧去投資. 老實說, 這是極度保守的建議. 而且美國國債也早就不行了. 故坊間幾乎都不掃描這部分的英文原稿, 更別說翻譯了.

[Note]

1. 高爐

Code Obfuscation 小筆記

我先跳做 code obfuscation (程式模糊化) 的目的, 假設大家都知道 why (為何而戰), 這裡只筆記 what and how? 

根據 [1], 我們可以做三種模糊化:

  1. Data Obfuscation
  2. Layout Obfuscation
  3. Control Obfuscation

Data obfuscation 是我們最熟悉的模糊化方式, 它是指對於變數名稱, 或者資料型態做修改. 事實上, 只要把 binary 中的 symbol strip 掉, 基本上名稱就變得亂七八糟了. 做法有二:

(1) compiler option [2]. 最厲害是 gcc 下開到 --strip=all. For object modules, this option removes all debug, comments, notes and symbols from the ELF file. For executables, this option works the same as --no_linkview.

(2) 用 command line 程式 off line 做 strip [3]. 最厲害也是開到 strip --strip=all, 不過以我粗淺地觀察, command line 多了針對特定 section 的操作, 而不是只把 section 分為 debug, comment, localsymbol, note…這幾種而已, 例如:

-R sectionname--remove-section=sectionname

附帶一提, section 的用法可以參照 ELF (Executable and Linkable format or Extensible Linking format) [4].   一個 ELF (*.o, *.so) 理所當然有一個 ELF header, 底下又分成 program header table, section, section header table 三個部分. 在 section header table 裡面就會記錄每一筆 section 在 image 中的那個位置 (offset).

至於對 data 的混淆, 個人有一點經驗可以分享. 上個世紀我做過 reverse engineering, 有一次我看到 binary 中有一串數字

5FFD:07D7 46 17 5D 74 D1 45 C7 3F dd 3FC745D1745D1746h ; 2/11
5FFD:07DF 1C C7 71 1C C7 71 CC 3F dd 3FCC71C71C71C1Ch ; 2/9
5FFD:07E7 92 24 49 92 24 49 D2 3F dd 3FD2492492492492h ; 2/7
5FFD:07EF 9A 99 99 99 99 99 D9 3F dd 3FD999999999999Ah ; 2/5
5FFD:07F7 55 55 55 55 55 55 E5 3F dd 3FE5555555555555h ; 2/3
5FFD:07FF 00 00 00 00 00 00 00 40 dd 4000000000000000h ; 2

因為太有規律了, 所以可以看出是 2/(2N+1) 的序列, 也就是:

2 * (1+1/3+1/5+1/7...)

此時搭配引用這段數字的代碼, 就可以看出是在計算:

2 * (x + x^3/3 + x^5/5 + x^7/7 + ....)

= ln(1+x) - ln(1-x)

= ln ((1+x)/(1-x))

諸如此類. 如果當初原作者把參數打亂一下, 我想破頭也很難想出來. 


Layout Obfuscation 是指修改 source code 的長相, 例如調整排縮 (indentation), 亂加 comment, 對 symbol 取怪名, 隨意插入不影響執行的關鍵字 [5]. 這對於已經編成 ELF 的程式當然沒用, 但是對於程式碼可直接執行的 java script 就有幫助.

Control Obfuscation 是指修改 code 的 statement 表示方式. 例如加入執行不到的 dead code, 該 call function 時把它的內容整個貼上來, 只用一個 function 但是把整包 library 塞進去. 看來這個手法主要是在 binary 的狀況下適用.

基本上, 如果做 binary release 可以用手法 1 和 3. 做 source code release 可以用手法 2. 不過接手這種 source code 的人應該心中 OOXX 吧…

[Note]

  1. Introduction to Code Obfuscation
  2. http://www.keil.com/support/man/docs/armclang_ref/armclang_ref_pge1362128923577.htm
  3. https://sourceware.org/binutils/docs/binutils/strip.html
  4. https://en.wikipedia.org/wiki/Executable_and_Linkable_Format
  5. https://codeobfus.files.wordpress.com/2010/04/layout-obfuscations.pdf

我讀 «證券分析» 第六版 – 價格與價值的背離

本書第 50 章講 “價格與價值的背離". 分析師一般不容易發現價格被低估的好標的 [1], 唯二的武器就是和同業比較以及分析公司的財務報表.

那麼分析師可以透過觀察股市週期性的波動 (包括過熱或是過分悲觀) 來盈利嗎? 作者說可以. 只要按照 SOP 就可以做到:

  1. 首先要建立一個清單, 內容要多樣化, 有領先地位 (例如道瓊成分股).
  2. 確定這些股票的正常股價. 例如 以 7~10 年間殖利率反推.
  3. 在正常值的 2/3 或 80% 時開始購買.
  4. 在高出正常值 1/3 或 20%~50% 時賣出.

這是羅傑巴柏森提出的方法, 幾乎跟小資女艾蜜莉講得一樣. 書上提到這個方法的缺點是對人類意志力的要求較高. 如果連續 13 年低迷 (1921-1933) 或是 3 年連漲 (1927-1929), 一般人會受不了 (p. 774).

當然, 作者也不贊同用槓桿來操作上面的 SOP. 他認為 “股票被低估" 跟 “股票一定會上漲" 是兩回事. 被低估是已經發生的事, 會上漲是預測未來 (p.775). 

至於買有名的股票好? 還是挖掘默默無名的股票好? 書上很明智地不做出結論, 而只是說市場的不理性可能沒有極限.  P. 777-P.778 提到許多被低估公司的清單: A 組公司 – 本益比小於 7,  B 組公司 – 股價低於流動資產的 2/3 且本益比小於 12. 勤奮的分析師不僅僅應該能從跟同業比較來判斷公司的價值是否被低估, 也應該要能看出公司是否真的很便宜. 上面這些公司都算是便宜.

然而, 如先前提到的公司要有領先地位才值得投資的話, 這些二等公司再怎麼便宜也不會被看上. 但 Graham 認為只要有一般的警覺性, 良好的判斷力, 又避免在市場過熱時投資, 買便宜的二等公司有很大的獲利機會 (P.779). 

有名公司因為收到大家的矚目, 一點風吹草動就會影響其股價. 二等公司的股價往往取決於是否有人去發掘它 (P. 780), 很容易就收到低估. 不論是股市過熱或是掉到谷底, 分析師都很難去推薦二等股票.

P.782 有一句話值得高光, “僅僅因為股息率從每年 5 美元增長到 6 美元就將股價提高 20 美元是很荒唐的, 這意味著以這個較高價格購買股票的人提前支付了未來 20 年中, 所有新股息率中獲得所有額外的股息." 翻譯成白話文就是如果股息增加, 股價還沒漲叫做便宜; 股價已經漲到位了, 多花的錢也只是再慢慢還給你而已 (順利的話).

P.783~P.785 講訴訟對股價的影響. 這裡並不是說 A 公司告 B 公司, B 公司股價跌了所以去撿便宜. 而是股東對於公司的訴訟, 例如股東不滿公司分割、併購等等. 本來股東對公司的訴訟就算失敗了也不過是 “as is", 若是成功了則股東的權益會上升, 但這邊舉的例子都是公司的股價受到訴訟而下跌到不合理的程度. 這種背離就是一個可以撿便宜的機會.

P.785~P.787 描述發行債券、優先股容易造成公司價格計算上的不直覺, 以至於算錯公司應有的價值. P. 788~790 說明併購、宣告破產的過程容易造成股價與價值背離. 

第 51 章持續講到高低知名度股票的差異.

  1. 高知名度的股票通常股價較穩定, 即使實際上變差了. 如果股價小幅下跌, 會有很多人願意進來撿便宜.
  2. 低知名度股票對壞消息非常敏感, 很容易跌到遠低於合理價之下.

低知名度股票雖然有這些劣勢, 但是假如一家低知名度公司發行一個利息保障倍數高達 12.6 倍的債券時, 看起來就具有一定的吸引力了. 因為公司只要不倒, 就會獲得強力的回報. 當然這是跟鼎鼎有名但利息保障倍數只有 2.1 倍的公司的債券相比. P. 794 舉了一家沒名氣的烘焙公司和一家有名的鋼鐵公司比較, 6 年後 (1925~1931) 小公司的利息保障倍數降到 8.1 倍, 當然是風險高了點, 但大公司的利息保障倍數更只剩一倍. P. 795 則是拿利息保障倍數 4.3 倍的小公司來舉例, 同樣 6 年後 (1922~1928), 利息倍數掉到 2.4 倍. 這種小便宜就不值得貪.

本章 P. 796~P. 799 講的是同一家公司的優先股、普通股、債券之間的價格背離. 先講結論: 如果公司發展愈來愈好, 那麼它每一種證券的價格都較容易正確估算, 普通股相對的會比較有利. 但如果公司前景變差, 優先股就會比較有利. 假設武漢肺炎變得更嚴重, 那優先股 ETF 比普通股容易領得到股息. 債券又比優先股更有保障. 如果我們能清楚分析出其中價值的背離, 我們可以在同一家公司的不同證券中做對沖 (P.796). 例如放空普通股買入債券之類的.

[Note]

  1. 連最近巴菲特都開始買 S&P500 了, 可見得現在的環境又比 Graham 的時代更困難.